LeetCode Hot 100 题解合集
索引#
哈希#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 1 | 两数之和 | 题解 |
| 中等 | 49 | 字母异位词分组 | 题解 |
| 中等 | 128 | 最长连续序列 | 题解 |
双指针#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 283 | 移动零 | 题解 |
| 中等 | 11 | 盛最多水的容器 | 题解 |
| 中等 | 15 | 三数之和 | 题解 |
滑动窗口#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 中等 | 3 | 无重复字符的最长子串 | 题解 |
| 中等 | 438 | 找到字符串中所有字母异位词 | 题解 |
子串#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 中等 | 560 | 和为 K 的子数组 | 题解 |
普通数组#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 中等 | 53 | 最大子数组和 | 题解 |
| 中等 | 56 | 合并区间 | 题解 |
| 中等 | 189 | 轮转数组 | 题解 |
| 中等 | 238 | 除自身以外数组的乘积 | 题解 |
矩阵#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 中等 | 73 | 矩阵置零 | 题解 |
| 中等 | 54 | 螺旋矩阵 | 题解 |
| 中等 | 48 | 旋转图像 | 题解 |
| 中等 | 240 | 搜索二维矩阵 II | 题解 |
链表#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 160 | 相交链表 | 题解 |
| 简单 | 206 | 反转链表 | 题解 |
| 简单 | 234 | 回文链表 | 题解 |
| 简单 | 141 | 环形链表 | 题解 |
| 简单 | 21 | 合并两个有序链表 | 题解 |
| 中等 | 142 | 环形链表 II | 题解 |
| 中等 | 2 | 两数相加 | 题解 |
| 中等 | 19 | 删除链表的倒数第 N 个结点 | 题解 |
| 中等 | 24 | 两两交换链表中的节点 | 题解 |
| 中等 | 148 | 排序链表 | 题解 |
| 中等 | 146 | LRU 缓存 | 题解 |
| 中等 | 138 | 随机链表的复制 | 题解 |
二叉树#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 94 | 二叉树的中序遍历 | 题解 |
| 简单 | 104 | 二叉树的最大深度 | 题解 |
| 简单 | 226 | 翻转二叉树 | 题解 |
| 简单 | 543 | 二叉树的直径 | 题解 |
| 简单 | 108 | 将有序数组转换为二叉搜索树 | 题解 |
| 中等 | 102 | 二叉树的层序遍历 | 题解 |
| 中等 | 98 | 验证二叉搜索树 | 题解 |
| 中等 | 230 | 二叉搜索树中第 K 小的元素 | 题解 |
| 中等 | 199 | 二叉树的右视图 | 题解 |
| 中等 | 114 | 二叉树展开为链表 | 题解 |
| 中等 | 105 | 从前序与中序遍历序列构造二叉树 | 题解 |
| 中等 | 437 | 路径总和 III | 题解 |
| 中等 | 236 | 二叉树的最近公共祖先 | 题解 |
图论#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 中等 | 200 | 岛屿数量 | 题解 |
| 中等 | 994 | 腐烂的橘子 | 题解 |
| 中等 | 207 | 课程表 | 题解 |
| 中等 | 208 | 实现 Trie (前缀树) | 题解 |
回溯法#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 中等 | 46 | 全排列 | 题解 |
| 中等 | 78 | 子集 | 题解 |
| 中等 | 17 | 电话号码的字母组合 | 题解 |
| 中等 | 39 | 组合总和 | 题解 |
| 中等 | 22 | 括号生成 | 题解 |
| 中等 | 79 | 单词搜索 | 题解 |
| 中等 | 131 | 分割回文串 | 题解 |
二分查找#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 35 | 搜索插入位置 | 题解 |
| 中等 | 74 | 搜索二维矩阵 | 题解 |
| 中等 | 34 | 在排序数组中查找元素的第一个和最后一个位置 | 题解 |
| 中等 | 33 | 搜索旋转排序数组 | 题解 |
| 中等 | 153 | 寻找旋转排序数组中的最小值 | 题解 |
栈#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 20 | 有效的括号 | 题解 |
| 中等 | 155 | 最小栈 | 题解 |
| 中等 | 394 | 字符串解码 | 题解 |
堆#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 中等 | 215 | 数组中的第K个最大元素 | 题解 |
| 中等 | 347 | 前 K 个高频元素 | 题解 |
贪心算法#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 121 | 买卖股票的最佳时机 | 题解 |
| 中等 | 55 | 跳跃游戏 | 题解 |
| 中等 | 45 | 跳跃游戏 II | 题解 |
| 中等 | 763 | 划分字母区间 | 题解 |
动态规划#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 70 | 爬楼梯 | 题解 |
| 简单 | 118 | 杨辉三角 | 题解 |
| 中等 | 198 | 打家劫舍 | 题解 |
| 中等 | 279 | 完全平方数 | 题解 |
| 中等 | 322 | 零钱兑换 | 题解 |
| 中等 | 139 | 单词拆分 | 题解 |
| 中等 | 300 | 最长递增子序列 | 题解 |
| 中等 | 152 | 乘积最大子数组 | 题解 |
| 中等 | 416 | 分割等和子集 | 题解 |
多维动态规划#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 中等 | 62 | 不同路径 | 题解 |
| 中等 | 64 | 最小路径和 | 题解 |
| 中等 | 5 | 最长回文子串 | 题解 |
| 中等 | 1143 | 最长公共子序列 | 题解 |
| 中等 | 72 | 编辑距离 | 题解 |
技巧#
| 难度 | 题号 | 题目 | 题解 |
|---|---|---|---|
| 简单 | 136 | 只出现一次的数字 | 题解 |
| 简单 | 169 | 多数元素 | 题解 |
| 中等 | 75 | 颜色分类 | 题解 |
| 中等 | 31 | 下一个排列 | 题解 |
| 中等 | 287 | 寻找重复数 | 题解 |
哈希#
1. 两数之和#
题目描述#
给定一个整数数组nums和一个整数目标值target,请你在该数组中找出和为目标值target的那两个整数,并返回它们的数组下标。
你可以假设每种输入只会对应一个答案,并且你不能使用两次相同的元素。
你可以按任意顺序返回答案。
示例:
输入:nums = [2,7,11,15], target = 9
输出:[0,1]
解释:因为 nums[0] + nums[1] == 9 ,返回 [0, 1]
核心思路#
该题目可以通过暴力枚举的方法计算出满足nums[i]+nums[j]=target的i和j,但是时间复杂度过高,因此采用哈希表的方法实现。 遍历nums数组中的每一个元素,若target-nums[i]不存在于哈希表中,则将num[i]作为key,i作为value插入哈希表。【可以避免nums中相同元素相加为target】 时间复杂度:由于哈希表查询的时间复杂度为O(1),因此,题目的复杂度取决于遍历nums数组,所以为O(n)
代码#
 1class Solution:
 2    def twoSum(self, nums: List[int], target: int) -> List[int]:
 3        hash_map={}
 4        #查询complement是否存在于hash_map中,若不存在,则将nums[i]插入hash_map
 5        for i in range(len(nums)):
 6            complement=target-nums[i]
 7            if complement in hashmap:
 8                return [i,hashmap[complement]]
 9            hash_map[nums[i]]=i
10        return []
49. 字母异位词分组#
题目描述#
给你一个字符串数组,请你将字母异位词组合在一起。可以按任意顺序返回结果列表。
字母异位词是由重新排列源单词的所有字母得到的一个新单词。
示例:
输入:strs = ["eat", "tea", "tan", "ate", "nat", "bat"]
输出:[["bat"],["nat","tan"],["ate","eat","tea"]]
核心思路#
可以通过哈希表存储由相同字母组成的单词列表。
- 创建一个空的哈希表。
- 对于 strs 中的每一个单词:
- 将其按字典序排序,得到 key。
- 若 key 不在哈希表中,则将 key 加入哈希表,并初始化对应的值为包含该未排序单词的列表。
- 若 key 已在哈希表中,将未排序单词添加到哈希表中 key 对应的列表中。
这样就能高效地将相同字母组成的单词分组。
代码#
 1class Solution:
 2    def groupAnagrams(self, strs: List[str]) -> List[List[str]]:
 3		# 创建一个defaultdict对象,默认值为空列表
 4        hashmap = defaultdict(list)
 5
 6        for word in strs:
 7            # 对每个单词进行排序,作为哈希表的key
 8            sortedWord = "".join(sorted(word))
 9            # 将未排序的单词加入到对应的key的列表中
10            hashmap[sortedWord].append(word)
11
12        # 直接返回哈希表中所有value的列表
13        return list(hashmap.values())
128. 最长连续序列#
题目描述#
给定一个未排序的整数数组nums,找出数字连续的最长序列(不要求序列元素在原数组中连续)的长度。
请你设计并实现时间复杂度为O(n)的算法解决此问题。
示例:
输入:nums = [100,4,200,1,3,2]
输出:4
解释:最长数字连续序列是 [1, 2, 3, 4]。它的长度为 4。
核心思路#
这个问题要求时间复杂度为O(n),可以使用哈希表(字典)来实现。
- 创建一个哈希表:
- 用来存储每个数对应的连续序列的长度。
- 遍历数组:
- 对于每个数,如果它已经在哈希表中,直接跳过。
- 如果是新数:
- 检查这个数的左右相邻数是否在哈希表中,取出它们对应的连续序列长度left和right。
- 计算当前数的连续序列长度:cur_length = left + right + 1。
- 更新最大长度max_length。
- 更新当前数及其连续序列两端点的长度为cur_length。
- 返回最大长度:
- 在遍历结束后,即可得到最长的连续序列长度。
代码#
 1class Solution:
 2    def longestConsecutive(self, nums):
 3        if not nums:
 4            # 如果输入列表为空,直接返回0
 5            return 0
 6
 7        # 创建一个哈希表,用于记录每个数所在序列的长度
 8        num_dict = {}
 9        max_length = 0
10
11        # 遍历数组中的每个数
12        for num in nums:
13            if num in num_dict:
14                # 如果当前数已经在哈希表中,跳过(避免重复计算)
15                continue
16
17            # 获取当前数左边和右边相邻数的连续序列长度
18            left = num_dict.get(num - 1, 0)
19            right = num_dict.get(num + 1, 0)
20
21            # 当前数所在连续序列的总长度
22            cur_length = left + right + 1
23
24            # 更新最大长度
25            max_length = max(max_length, cur_length)
26
27            # 更新当前数及其连续序列两端点的长度信息
28            num_dict[num] = cur_length
29            num_dict[num - left] = cur_length
30            num_dict[num + right] = cur_length
31
32        # 返回最长的连续序列长度
33        return max_length
双指针#
283. 移动零#
题目描述#
给定一个数组nums,编写一个函数将所有0移动到数组的末尾,同时保持非零元素的相对顺序。
请注意,必须在不复制数组的情况下原地对数组进行操作。
示例
输入: nums = [0,1,0,3,12]
输出: [1,3,12,0,0]
核心思路#
采用类似快排的划分思想,以非0数为基准,左边为非零数,右边为0,通过zeroindex记录第一个为0的元素的下标。然后循环遍历nums数组,当nums[i]!=0时,nums[i]和nums[zeroindex]进行交换,然后zeroindex++ 时间复杂度:O(n),空间复杂度:O(1)
代码#
 1class Solution:
 2    def moveZeroes(self, nums: List[int]) -> None:
 3        zeroindex=-1
 4        for i in range(len(nums)):
 5            if nums[i]==0 and zeroindex==-1:
 6                zeroindex=i
 7            elif nums[i]!=0 and zeroindex!=-1:
 8                nums[zeroindex],nums[i]=nums[i],nums[zeroindex]
 9                zeroindex+=1
10        return nums
11. 盛最多水的容器#
题目描述#
给定一个长度为n的整数数组height。有n条垂线,第i条线的两个端点是(i, 0)和(i, height[i])。
找出其中的两条线,使得它们与x轴共同构成的容器可以容纳最多的水。
返回容器可以储存的最大水量。
说明:你不能倾斜容器。
示例:
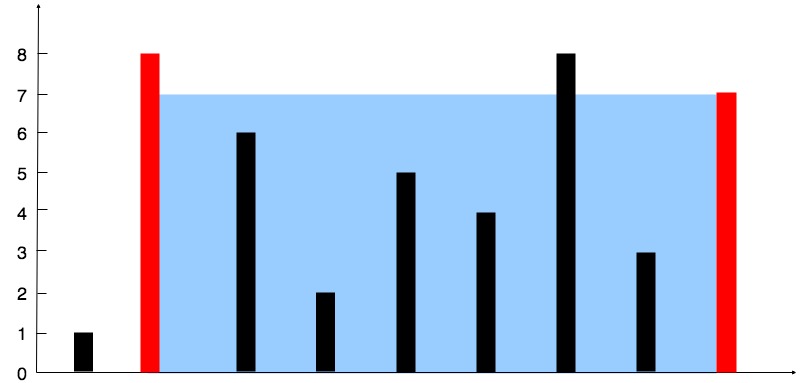
输入:[1,8,6,2,5,4,8,3,7]
输出:49
解释:图中垂直线代表输入数组 [1,8,6,2,5,4,8,3,7]。在此情况下,容器能够容纳水(表示为蓝色部分)的最大值为49。
核心思路#
采用双指针的方法实现。
- 初始化指针和变量:
- start指向height数组的最左端。
- end指向height数组的最右端。
- max_volume初始化为0。
- 循环计算盛水容积,并更新指针:
- 当start < end时,重复以下步骤:
- 计算当前容积:volume = min(height[start], height[end]) * (end - start)
- 更新最大容积: 若volume > max_volume,则max_volume = volume
- 移动较小值对应的指针:
- 若height[start]小于height[end],则start += 1
- 否则,end -= 1
- 当start < end时,重复以下步骤:
- 循环结束时,max_volume即为最大容积。
代码#
 1class Solution:
 2    def maxArea(self, height: List[int]) -> int:
 3        start, end = 0, len(height) - 1
 4        max_volume = 0
 5
 6        while start < end:
 7            volume = min(height[start], height[end]) * (end - start)
 8            max_volume = max(max_volume, volume)
 9
10            if height[start] < height[end]:
11                start += 1
12            else:
13                end -= 1
14
15        return max_volume
15. 三数之和#
题目描述#
给你一个整数数组nums,判断是否存在三元组[nums[i], nums[j], nums[k]]满足i != j、i != k且j != k,同时还满足nums[i] + nums[j] + nums[k] == 0。请你返回所有和为0且不重复的三元组。
注意:答案中不可以包含重复的三元组。
示例:
输入:nums = [-1,0,1,2,-1,-4]
输出:[[-1,-1,2],[-1,0,1]]
解释:
nums[0] + nums[1] + nums[2] = (-1) + 0 + 1 = 0 。
nums[1] + nums[2] + nums[4] = 0 + 1 + (-1) = 0 。
nums[0] + nums[3] + nums[4] = (-1) + 2 + (-1) = 0 。
不同的三元组是 [-1,0,1] 和 [-1,-1,2] 。
注意,输出的顺序和三元组的顺序并不重要。
核心思路#
- 特殊情况处理:如果数组为 null 或者数组长度小于 3,直接返回空结果。
- 对数组进行排序。
- 遍历排序后的数组:
- 如果当前数 nums[i] 大于 0,因为数组已经排序,所以后面的数都大于 0,无法找到三个数的和为 0,因此直接返回空列表。
- 如果当前数与前一个数相同,跳过以避免重复解。
- 设定两个指针,左指针 L 初始化为 i+1,右指针 R 初始化为数组末尾。
- 在 L < R 的情况下,计算 nums[i] + nums[L] + nums[R] 的和:
- 如果和为 0,记录这个三元组,并移动 L 和 R 指针,跳过重复元素。
- 如果和大于 0,说明 nums[R] 太大,右指针左移。
- 如果和小于 0,说明 nums[L] 太小,左指针右移。
复杂度分析:
- 时间复杂度:排序需要 O(nlog n),遍历数组和双指针查找的时间复杂度为 O(n^2),总体复杂度为 O(n^2)
- 空间复杂度:O(1)
代码#
 1class Solution:
 2    def threeSum(self, nums: List[int]) -> List[List[int]]:
 3        if len(nums) < 3: return []
 4        nums.sort()
 5        result = []
 6
 7        for i in range(len(nums)):
 8            if nums[i] > 0: break
 9            if i > 0 and nums[i] == nums[i - 1]: continue
10
11            L, R = i + 1, len(nums) - 1
12            while L < R:
13                total = nums[i] + nums[L] + nums[R]
14                if total == 0:
15                    result.append([nums[i], nums[L], nums[R]])
16                    while L < R and nums[L] == nums[L + 1]:
17                        L += 1
18                    while L < R and nums[R] == nums[R - 1]:
19                        R -= 1
20                    L += 1
21                    R -= 1
22                elif total < 0:
23                    L += 1
24                else:
25                    R -= 1
26
27        return result
滑动窗口#
3. 无重复字符的最长子串#
题目描述#
给定一个字符串s,请你找出其中不含有重复字符的最长子串 的长度。
示例:
输入: s = "abcabcbb"
输出: 3
解释: 因为无重复字符的最长子串是 `"abc"`,所以其长度为 3。
核心思路#
目标是找到字符串中最长的无重复字符的子串。
- 初始化:
- 我们定义两个指针start和end,用于表示滑动窗口的起始和结束位置。
- 一个哈希集合(HashSet)用来存储当前窗口内的字符,从而帮助我们检测是否有重复字符。
- 滑动窗口的操作:
- 扩展窗口:将end指针向右移动,即增大窗口的范围。
- 检查重复:每次移动end后,我们检查新加入窗口的字符s[end]。
- 如果s[end]已经存在于集合中,说明出现了重复字符,此时需要缩小窗口。
- 为了缩小窗口,我们移动start指针,直到没有重复字符为止。在移动start的过程中,需要将移出窗口的字符从集合中删除。
- 更新最大长度:
- 在窗口内没有重复字符时,计算当前窗口的长度(end - start + 1),并更新记录的最大长度。
- 继续上述过程,直到end指针遍历完整个字符串。
复杂度分析: - 时间复杂度为 O(n),因为每个字符在最坏情况下只会被访问两次(一次被加入集合,一次被移出集合)。
代码#
 1class Solution:
 2    def lengthOfLongestSubstring(self, s: str) -> int:
 3        if not s:
 4            return 0
 5
 6        # 初始化指针和结果变量
 7        start, max_length = 0, 0
 8        char_index_map = {}  # 用于存储字符及其最后出现的位置
 9
10        for end in range(len(s)):
11            if s[end] in char_index_map and char_index_map[s[end]] >= start:
12                # 如果当前字符已经存在于字典中且其索引在start之后或等于start,说明有重复字符,
13                # 需要移动start指针,以排除重复字符
14                start = char_index_map[s[end]] + 1
15
16            # 更新字符的最新索引位置
17            char_index_map[s[end]] = end
18
19            # 更新最长无重复子串的长度
20            max_length = max(max_length, end - start + 1)
21
22        return max_length
438. 找到字符串中所有字母异位词#
题目描述#
给定两个字符串s和p,找到s中所有p的异位词的子串,返回这些子串的起始索引。不考虑答案输出的顺序。
异位词指由相同字母重排列形成的字符串(包括相同的字符串)。
示例:
输入:s = "cbaebabacd", p = "abc"
输出:[0,6]
解释:
起始索引等于 0 的子串是 "cba", 它是 "abc" 的异位词。
起始索引等于 6 的子串是 "bac", 它是 "abc" 的异位词。
核心思路#
【方法一:滑动窗口 + 计数器】
- 初始化计数器: 初始化 p_count 和 s_count 各需要 O(n) 时间,其中 n 是字符串 p 的长度。
- 滑动窗口过程:
- 每次移动窗口时,添加新字符和移除老字符的操作都是 O(1) 时间复杂度。
- 比较两个字典是否相等(s_count == p_count)的时间复杂度是 O(1),因为字典的键数固定为 26(即字符集大小)。
因此,这种方法的总时间复杂度为 O(m + (m-n+1) * 1) = O(m) ,其中 m 是字符串 s 的长度。
【方法二:滑动窗口 + 排序】
- 初始化排序: 对字符串 p 进行排序需要 O(n log n) 时间。
- 滑动窗口过程:
- 每次移动窗口时,对滑动窗口内的字符串进行排序,时间复杂度是 O(n log n),其中 n 是窗口大小(即 p 的长度)。
- 比较两个排序后的字符串的时间复杂度是 O(n)。
因此,这种方法的总时间复杂度为 O((m-n+1) * (n log n + n)) = O((m-n+1) * n log n),其中 m 是字符串 s 的长度。
代码#
【方法一:滑动窗口 + 计数器】
 1class Solution:
 2    def findAnagrams(self, s: str, p: str) -> List[int]:
 3        # 初始化 p 的字符计数器和滑动窗口的字符计数器
 4        p_count = Counter(p)
 5        s_count = Counter(s[:len(p)-1])
 6
 7        result = []
 8        # 遍历字符串 s,从索引 len(p)-1 到 len(s)-1
 9        #窗口头指针:i-len(p)+1
10        #窗口尾指针:i
11        for i in range(len(p)-1, len(s)):
12            # 将新的字符加入当前滑动窗口的计数器中
13            s_count[s[i]] += 1
14
15            # 如果当前窗口的字符计数器与 p 的字符计数器相同,则记录起始索引
16            if s_count == p_count:
17                result.append(i - len(p) + 1)
18
19            # 移除当前窗口左侧即将滑出字符的计数
20            s_count[s[i - len(p) + 1]] -= 1
21            # 如果某个字符的计数变为零,将其从计数器中删除
22            if s_count[s[i - len(p) + 1]] == 0:
23                del s_count[s[i - len(p) + 1]]
24
25        return result
子串#
560. 和为 K 的子数组#
题目描述#
给你一个整数数组nums和一个整数k,请你统计并返回该数组中和为k的子数组的个数。
子数组是数组中元素的连续非空序列。
示例:
输入:nums = [1,1,1], k = 2
输出:2
核心思路#
首先,我们了解问题要求是找到和为 k 的子数组。这意味着我们需要计算很多子数组的和。如果使用暴力方法逐个计算所有可能的子数组和,将会导致时间复杂度非常高,达到 O(n^2) 或更高。在大型数据集上,这种方法效率极低。
前缀和(Prefix Sum) 为了解决上述问题,可以引入前缀和的概念。前缀和是从数组的起点到当前位置的元素总和。有了前缀和,任意子数组的和可以通过两个前缀和之差快速计算出来:如果我们知道从起点到第 j 个位置的前缀和 prefix_sum_j 和从起点到第 i 个位置的前缀和 prefix_sum_i,那么从 i+1 到 j 的子数组的和为 prefix_sum_j - prefix_sum_i。
哈希表优化查找 为了快速查找某个前缀和是否存在,以及其出现次数,我们可以使用哈希表。当遍历数组时,我们记录每个前缀和及其出现的次数。这样我们就能快速判断之前是否有某个前缀和使得当前前缀和减去它等于 k。
解题步骤的推导
初始化:
- prefix_sum = 0: 表示初始的前缀和。
- prefix_sum_count = {0: 1}: 初始化哈希表,表示前缀和为0的情况出现一次。这一步很重要,它处理了当从数组开头到某个位置子数组和恰好为 k 的情况。
遍历数组:
- 对每个元素,更新当前前缀和 prefix_sum。
- 检查 prefix_sum - k 是否在 prefix_sum_count 中:如果在,说明存在之前的一个前缀和,使得这段区间的和为 k,于是增加计数器。
- 将当前前缀和加入或更新到 prefix_sum_count 中。
代码#
 1class Solution:
 2    def subarraySum(self, nums: List[int], k: int) -> int:
 3        prefix_sum = 0  # 初始化前缀和
 4        prefix_sum_count = {0: 1}  # 初始化哈希表,包含前缀和为0的情况
 5        count = 0  # 初始化计数器
 6
 7        for num in nums:
 8            prefix_sum += num  # 更新当前前缀和
 9            count += prefix_sum_count.get(prefix_sum - k, 0)  # 如果存在符合条件的前缀和,则增加计数
10            prefix_sum_count[prefix_sum] = prefix_sum_count.get(prefix_sum, 0) + 1  # 更新当前前缀和出现次数
11
12        return count  # 返回计数结果
普通数组#
53. 最大子数组和#
题目描述#
给你一个整数数组nums,请你找出一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。
子数组是数组中的一个连续部分。
示例:
输入:nums = [-2,1,-3,4,-1,2,1,-5,4]
输出:6
解释:连续子数组[4,-1,2,1] 的和最大,为6 。
核心思路#
动态规划思路(Kadane算法)
Kadane算法是一种线性时间复杂度O(n)的动态规划算法,用来解决最大子数组和问题。该算法的核心在于通过迭代数组,计算以每个位置结尾的子数组的最大和,并实时更新全局最大和。
- 初始条件:
- 使用一个变量current_sum来表示当前子数组的和。
- 使用另一个变量max_sum来记录找到的最大和。
- 初始化current_sum和max_sum为数组的第一个元素,因为单独一个元素也是一个子数组。
- 迭代数组:
- 从第二个元素开始遍历数组。
- 对于每个元素nums[i],current_sum = max(nums[i], current_sum + nums[i])。
- 如果current_sum + nums[i]比nums[i]大,则意味着延续前面的子数组是有益的。
- 否则,从当前元素重新开始一个新的子数组。
- 更新全局最大和:max_sum = max(max_sum, current_sum),这样可以确保max_sum永远是我们迄今为止找到的最大子数组和。
- 返回结果:
- 最后,max_sum就是所求的具有最大和的连续子数组的和。
代码#
 1class Solution:
 2    def maxSubArray(self, nums: List[int]) -> int:
 3        # 初始化当前子数组和和最大子数组和为第一个元素
 4        current_sum = max_sum = nums[0]
 5
 6        # 从第二个元素开始遍历数组
 7        for num in nums[1:]:
 8            # 当前子数组和的计算
 9            current_sum = max(num, current_sum + num)
10            # 更新全局最大和
11            max_sum = max(max_sum, current_sum)
12
13        return max_sum
56. 合并区间#
题目描述#
以数组intervals表示若干个区间的集合,其中单个区间为intervals[i] = [starti, endi]。请你合并所有重叠的区间,并返回一个不重叠的区间数组,该数组需恰好覆盖输入中的所有区间。
示例:
输入:intervals = [[1,3],[2,6],[8,10],[15,18]]
输出:[[1,6],[8,10],[15,18]]
解释:区间 [1,3] 和 [2,6] 重叠, 将它们合并为 [1,6].
核心思路#
- 排序:首先按照每个区间的起始值对intervals进行排序。
- 初始化结果列表:创建一个空列表merged用于存储最终的合并结果。
- 遍历区间:
- 如果merged为空或者当前区间与merged的最后一个区间不重叠,将当前区间加入merged。
- 否则,合并当前区间与merged的最后一个区间。
代码#
 1class Solution:
 2    def merge(self, intervals: List[List[int]]) -> List[List[int]]:
 3        # 按起始值排序区间
 4        intervals.sort(key=lambda x: x[0])
 5        merged_intervals = []
 6
 7        for current in intervals:
 8            if not merged_intervals or merged_intervals[-1][1] < current[0]:
 9                merged_intervals.append(current)
10            else:
11                merged_intervals[-1][1] = max(merged_intervals[-1][1], current[1])
12
13        return merged_intervals
189. 轮转数组#
题目描述#
给定一个整数数组nums,将数组中的元素向右轮转k个位置,其中k是非负数。
示例:
输入:nums = [1,2,3,4,5,6,7], k = 3
输出:[5,6,7,1,2,3,4]
解释:
向右轮转 1 步: [7,1,2,3,4,5,6]
向右轮转 2 步: [6,7,1,2,3,4,5]
向右轮转 3 步: [5,6,7,1,2,3,4]
核心思路#
【方法一】
- 计算有效的旋转步数: 通过k = k % n,确保旋转步数不超过数组长度。
- 切片操作重新排列数组:
- 使用nums[-k:]获取数组末尾k个元素。
- 使用nums[:-k]获取数组前面部分。
- 将这两个部分拼接起来形成新的数组顺序,并赋值给原数组nums[:]。
- 时间复杂度:(O(n))。切片操作需要遍历整个数组,因此时间复杂度为 (O(n))。
- 空间复杂度:(O(n))。虽然没有显式地使用额外的数据结构,但切片操作会产生临时数组,占用额外的空间。
【方法二】
- 整体翻转数组:将整个数组完全反转。
- 翻转前k个元素:将前k个元素再次反转。
- 翻转后n-k个元素:将后n-k个元素再次反转。
- 时间复杂度:(O(n))。每次翻转操作需要遍历部分或者整个数组,总共三次翻转,因此时间复杂度为 (O(n))。
- 空间复杂度:(O(1))。只使用了常数个额外空间用于变量存储,没有使用额外的数据结构。
代码#
【方法一】
1class Solution:
2    def rotate(self, nums: List[int], k: int) -> None:
3        n = len(nums)
4        k = k % n  # 防止 k 超过数组长度
5        nums[:] = nums[-k:] + nums[:-k]
【方法二】
 1class Solution:
 2    def rotate(self, nums: List[int], k: int) -> None:
 3        n = len(nums)
 4        k = k % n  # 防止 k 超过数组长度
 5
 6        def reverse(start: int, end: int) -> None:
 7            while start < end:
 8                nums[start], nums[end] = nums[end], nums[start]
 9                start += 1
10                end -= 1
11
12        reverse(0, n - 1)
13        reverse(0, k - 1)
14        reverse(k, n - 1)
238. 除自身以外数组的乘积#
题目描述#
给你一个整数数组nums,返回 数组answer,其中answer[i]等于nums中除nums[i]之外其余各元素的乘积。
题目数据保证数组nums之中任意元素的全部前缀元素和后缀的乘积都在32 位整数范围内。
请不要使用除法,且在O(n)时间复杂度内完成此题。
示例:
输入:nums = [1,2,3,4]
输出:[24,12,8,6]
核心思路#
我们需要找到一个不包含nums[i]的数组乘积,并且要求时间复杂度为O(n)且不使用除法。可以通过前缀积和后缀积的方法来实现。
- 计算前缀积:创建一个与输入数组等长的结果数组answer。首先将answer初始化为全1,然后遍历一遍数组,将每个位置的值替换为该位置之前所有元素的乘积。
- 计算后缀积:在同一个结果数组中从后向前遍历,同时维护一个变量suffix_product表示从当前元素到最后一个元素的乘积。将answer中的每个元素与suffix_product相乘,然后更新suffix_product。
通过上述方法,我们可以在一次遍历中完成前缀积的计算,另一遍遍历中完成后缀积的计算,从而满足O(n)的时间复杂度要求。同时,借助结果数组本身来存储计算结果,实现了O(1)的空间复杂度(不包括输出数组)。
代码#
 1class Solution:
 2    def productExceptSelf(self, nums: List[int]) -> List[int]:
 3        n = len(nums)
 4        answer = [1] * n  # 初始化结果数组,全1
 5        # 计算前缀积并存储在 answer 中
 6        for i in range(1, n):
 7            answer[i] = answer[i - 1] * nums[i - 1]
 8
 9        suffix_product = 1  # 初始化后缀积为1
10        # 计算后缀积,并直接更新 answer
11        for i in range(n - 1, -1, -1):  # 从后往前遍历数组
12            answer[i] *= suffix_product  # 将当前后缀积乘以 answer 中对应位置的值
13            suffix_product *= nums[i]  # 更新后缀积
14
15        return answer
矩阵#
73. 矩阵置零#
题目描述#
给定一个m×n的矩阵,如果一个元素为0,则将其所在行和列的所有元素都设为0。请使用原地算法。
示例:
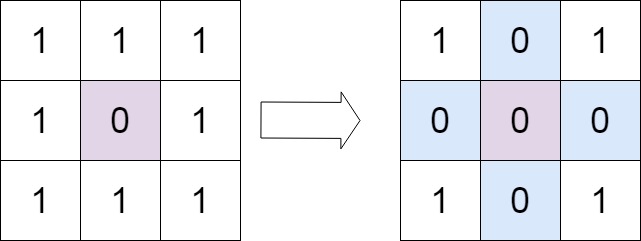
输入:matrix = [[1,1,1],[1,0,1],[1,1,1]]
输出:[[1,0,1],[0,0,0],[1,0,1]]
核心思路#
要解决这个问题,可以使用矩阵的第一行和第一列作为标记,来记录哪些行和哪些列需要被设为0。这样可以避免使用额外的空间。
检查第一行和第一列是否有0:首先检查矩阵的第一行和第一列中是否有0,因为这两个位置会被用来标记其他行和列。
使用第一行和第一列作为标记:遍历矩阵的其余部分(从第二行和第二列开始),如果某个元素是0,就将该元素所在的行的第一个元素和列的第一个元素设为0,作为标记。
根据标记设置0:再次遍历矩阵(从第二行和第二列开始),如果某个元素所在的行的第一个元素或列的第一个元素是0,就将该元素设为0。
处理第一行和第一列:最后,根据第一步中记录的信息,决定是否将第一行和第一列全部设为0。
代码#
 1class Solution:
 2    def setZeroes(self, matrix: List[List[int]]) -> None:
 3        m, n = len(matrix), len(matrix[0])
 4
 5        # 检查第一行是否有0
 6        first_row_has_zero = any(matrix[0][j] == 0 for j in range(n))
 7        # 检查第一列是否有0
 8        first_col_has_zero = any(matrix[i][0] == 0 for i in range(m))
 9
10        # 使用第一行和第一列作为标记
11        for i in range(1, m):
12            for j in range(1, n):
13                if matrix[i][j] == 0:
14                    matrix[i][0] = 0  # 标记第i行需要变为0
15                    matrix[0][j] = 0  # 标记第j列需要变为0
16
17        # 根据标记设置0
18        for i in range(1, m):
19            for j in range(1, n):
20                if matrix[i][0] == 0 or matrix[0][j] == 0:
21                    matrix[i][j] = 0
22
23        # 处理第一行,如果第一行原来存在0,则将第一行全部变为0
24        if first_row_has_zero:
25            for j in range(n):
26                matrix[0][j] = 0
27
28        # 处理第一列,如果第一列原来存在0,则将第一列全部变为0
29        if first_col_has_zero:
30            for i in range(m):
31                matrix[i][0] = 0
54. 螺旋矩阵#
题目描述#
给你一个m行n列的矩阵matrix,请按照顺时针螺旋顺序,返回矩阵中的所有元素。
示例:
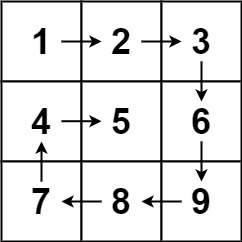
输入:matrix = [[1,2,3],[4,5,6],[7,8,9]]
输出:[1,2,3,6,9,8,7,4,5]
核心思路#
这道题可以通过模拟螺旋遍历的方式来解决。核心思想是按照顺时针方向逐步缩小遍历的范围,直到遍历完整个矩阵。
初始化边界:定义四个边界变量 top, bottom, left, right,分别表示当前未遍历的矩阵的上、下、左、右边界。
循环遍历:
- 从左到右:遍历 left 到 right 的顶部行,然后将 top 下移一行。
- 从上到下:遍历 top 到 bottom 的右侧列,然后将 right 左移一列。
- 从右到左:遍历 right 到 left 的底部行,然后将 bottom 上移一行。
- 从下到上:遍历 bottom 到 top 的左侧列,然后将 left 右移一列。
终止条件:当 top 超过 bottom 或 left 超过 right 时,遍历结束。
通过这种方式,可以确保每个元素只被访问一次,并且按照顺时针螺旋顺序返回所有元素。
代码#
 1class Solution:
 2    def spiralOrder(self, matrix: List[List[int]]) -> List[int]:
 3        if not matrix or not matrix[0]:
 4            return []
 5
 6        m, n = len(matrix), len(matrix[0])
 7        top, bottom, left, right = 0, m - 1, 0, n - 1
 8        result = []
 9
10        while top <= bottom and left <= right:
11            # 从左到右遍历顶部行
12            for i in range(left, right + 1):
13                result.append(matrix[top][i])
14            top += 1  # 顶部行已遍历,下移一行
15
16            # 从上到下遍历右侧列
17            for i in range(top, bottom + 1):
18                result.append(matrix[i][right])
19            right -= 1  # 右侧列已遍历,左移一列
20
21            # 检查是否还有剩余的行和列
22            if top <= bottom:
23                # 从右到左遍历底部行
24                for i in range(right, left - 1, -1):
25                    result.append(matrix[bottom][i])
26                bottom -= 1  # 底部行已遍历,上移一行
27
28            if left <= right:
29                # 从下到上遍历左侧列
30                for i in range(bottom, top - 1, -1):
31                    result.append(matrix[i][left])
32                left += 1  # 左侧列已遍历,右移一列
33
34        return result
48. 旋转图像#
题目描述#
给定一个_n_×_n_的二维矩阵matrix表示一个图像。请你将图像顺时针旋转 90 度。
你必须在 原地 旋转图像,这意味着你需要直接修改输入的二维矩阵。请不要使用另一个矩阵来旋转图像。
示例:
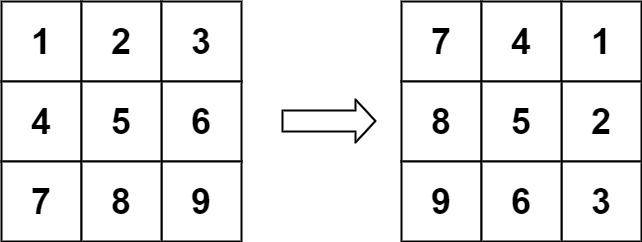
输入:matrix = [[1,2,3],[4,5,6],[7,8,9]]
输出:[[7,4,1],[8,5,2],[9,6,3]]
核心思路#
确定层数:
- 对于一个 n × n 的矩阵,旋转层数为 n // 2
逐层旋转:
- 每次选择一个层,从 top 行开始,按顺时针方向交换四个角上的元素
具体元素交换:
对于每个需要旋转的层和边界:- matrix[top][i] 表示当前层的上边元素,存储到临时变量 temp 中。
- 左边元素 matrix[bottom - offset][top] 移到上边。
- 下边元素 matrix[bottom][bottom - offset] 移到左边。
- 右边元素 matrix[i][bottom] 移到下边。
- 最后将存储的 temp 移到右边。
代码#
 1class Solution:
 2    def rotate(self, matrix: List[List[int]]) -> None:
 3        n = len(matrix)
 4
 5        # 逐层旋转
 6        for layer in range(n // 2):
 7            # 当前层的边界
 8            top, bottom = layer, n - 1 - layer
 9
10            for i in range(top, bottom):
11                # 计算偏移量
12                offset = i - top
13
14                # 顺时针旋转四个位置
15
16                # 保存上边元素
17                temp = matrix[top][i]
18                # 左 -> 上
19                matrix[top][i] = matrix[bottom - offset][top]
20                # 下 -> 左
21                matrix[bottom - offset][top] = matrix[bottom][bottom - offset]
22                # 右 -> 下
23                matrix[bottom][bottom - offset] = matrix[i][bottom]
24                # 上 -> 右
25                matrix[i][bottom] = temp
240. 搜索二维矩阵 II#
题目描述#
编写一个高效的算法来搜索m×n矩阵matrix中的一个目标值target。该矩阵具有以下特性:
- 每行的元素从左到右升序排列。
- 每列的元素从上到下升序排列。
示例:
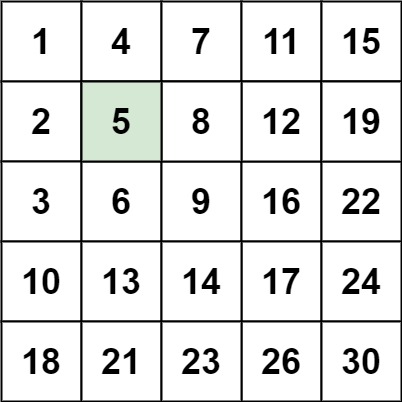
输入:matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 5
输出:true
核心思路#
从矩阵的右上角开始搜索,这样每一步都可以通过比较大小来确定下一步的方向。详细步骤如下:
从右上角开始:我们选择从矩阵的右上角(即第一行的最后一个元素)开始。这个位置有一个特殊的性质:
- 如果当前元素比目标值 target 大,我们可以往左移动,因为同一行左边的元素更小。
- 如果当前元素比目标值 target 小,我们可以向下移动,因为同一列下面的元素更大。
不断缩小搜索空间:根据上面的逻辑,我们每次都可以抛弃一整行或一整列,因此每次比较都有效地缩小了搜索范围。
终止条件:如果找到了目标值,返回 True。如果搜索越界(即行列索引超出矩阵范围),则返回 False,表示未找到目标值。
代码#
 1class Solution:
 2    def searchMatrix(self, matrix: List[List[int]], target: int) -> bool:
 3        # 获取矩阵的行数和列数
 4        if not matrix or not matrix[0]:
 5            return False
 6        rows, cols = len(matrix), len(matrix[0])
 7
 8        # 从右上角开始
 9        row, col = 0, cols - 1
10
11        while row < rows and col >= 0:
12            if matrix[row][col] == target:
13                return True
14            elif matrix[row][col] > target:
15                # 如果当前元素比目标大,向左移动
16                col -= 1
17            else:
18                # 如果当前元素比目标小,向下移动
19                row += 1
20
21        return False
链表#
160. 相交链表#
题目描述#
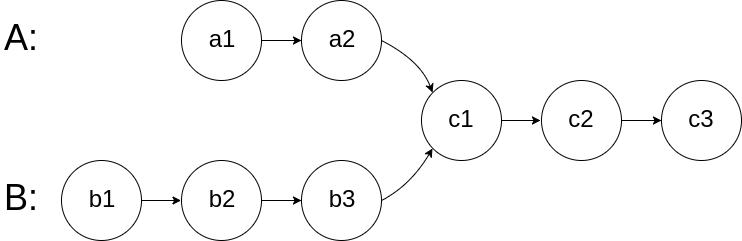
给你两个单链表的头节点headA和headB,请你找出并返回两个单链表相交的起始节点。如果两个链表不存在相交节点,返回null。
图示两个链表在节点c1开始相交,题目数据保证整个链式结构中不存在环。
注意,函数返回结果后,链表必须保持其原始结构。
示例:

输入:intersectVal = 8, listA = [4,1,8,4,5], listB = [5,6,1,8,4,5], skipA = 2, skipB = 3
输出:Intersected at '8'
解释:相交节点的值为8(注意,如果两个链表相交则不能为0)。
从各自的表头开始算起,链表 A 为 [4,1,8,4,5],链表 B 为 [5,6,1,8,4,5]。
在 A 中,相交节点前有 2 个节点;在 B 中,相交节点前有 3 个节点。
请注意相交节点的值不为 1,因为在链表 A 和链表 B 之中值为 1 的节点 (A 中第二个节点和 B 中第三个节点) 是不同的节点。换句话说,它们在内存中指向两个不同的位置,而链表 A 和链表 B 中值为 8 的节点 (A 中第三个节点,B 中第四个节点) 在内存中指向相同的位置。
核心思路#
假设两个链表分别为A和B,并且它们在某一点相交。设A的长度为m,B的长度为n,交点之前的部分长度分别为a和b,交点之后的部分长度为c。
- 如果两个链表没有交点,那么indexA和indexB最终都会到达None,从而退出循环。
- 如果有交点,由于两个指针都会遍历完自己的链表后再遍历对方的链表,因此它们会在交点处相遇。
代码#
1class Solution:
2	def getIntersectionNode(self, headA: ListNode, headB: ListNode) -> Optional[ListNode]:
3		indexA, indexB = headA, headB
4		while indexA != indexB:
5			indexA = indexA.next if indexA else headB
6			indexB = indexB.next if indexB else headA
7		return indexA
206. 反转链表#
题目描述#
给你单链表的头节点head,请你反转链表,并返回反转后的链表。
示例:

输入:head = [1,2,3,4,5]
输出:[5,4,3,2,1]
核心思路#
反转链表的基本思路是遍历链表,并将每个节点的next指针从指向它的下一个节点改为指向前一个节点。为了做到这一点,我们需要维护三个指针:
- prev:指向当前节点的前一个节点。
- current:指向当前节点。
- next_node:指向当前节点的下一个节点。
代码#
 1class Solution:
 2    def reverseList(self, head: Optional[ListNode]) -> Optional[ListNode]:
 3        if not head:
 4            return None
 5        # 初始化前驱节点和当前节点
 6        prev = None
 7        current = head
 8        # 遍历链表,反转指针
 9        while current:
10            next_node = current.next
11            # 反转指针
12            current.next = prev
13            # 移动前驱节点和当前节点
14            prev = current
15            current = next_node
16
17        # 返回新的头节点(即原链表的最后一个节点)
18        return prev
234. 回文链表#
题目描述#
给你一个单链表的头节点head,请你判断该链表是否为回文链表。如果是,返回true;否则,返回false。
示例:
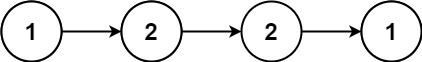
输入:head = [1,2,2,1]
输出:true
核心思路#
方法一:链表转化为数组 可以遍历链表,并将其中的元素存储在数组中,然后使用首尾双指针判断数组是否为回文数组。 时间复杂度:O(n),空间复杂度:O(n) 【方法二】 为了降低空间复杂度,改变链表结构,将链表后半部分及进行逆序,然后和链表前半部分的数据进行比较,判断是否为回文。
步骤一:使用快慢指针寻找到链表中间位置。初始化慢指针slow和快指针fast为链表头指针head,slow每次移动一位,fast每次移动两位,最终在fast为空时,slow指针指向链表的中间位置,将链表分为了两个部分。在接下来的步骤中,会对这两个部分是否为回文进行判断。 步骤二:以slow为头节点,将slow指向的后半部分指针进行逆序排序。【参考反转链表】 步骤三:将反转后的链表和以head节点为首的链表前半部分按照次序进行比较,若出现不相等的值,则返回False;反之最终返回True
代码#
 1class Solution:
 2    def isPalindrome(self, head: Optional[ListNode]) -> bool:
 3        if not head or not head.next:
 4            return True
 5        # 步骤一:使用快慢指针寻找到链表中间位置
 6        slow, fast = head, head
 7        while fast and fast.next:
 8            slow = slow.next
 9            fast = fast.next.next
10        # 步骤二:对于链表后半部分进行反转
11        def reverseLink(head):
12            prev = None
13            current = head
14            while current:
15                next_node = current.next
16                current.next = prev
17                prev = current
18                current = next_node
19            return prev
20        slow = reverseLink(slow)
21        # 步骤三:判断是否为回文链表
22        while slow:
23            if slow.val != head.val:
24                return False
25            slow, head = slow.next, head.next
26        return True
141. 环形链表#
题目描述#
给你一个链表的头节点head,判断链表中是否有环。
如果链表中有某个节点,可以通过连续跟踪next指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数pos来表示链表尾连接到链表中的位置(索引从 0 开始)。注意:pos不作为参数进行传递。仅仅是为了标识链表的实际情况。
如果链表中存在环,则返回true。 否则,返回false。
示例:
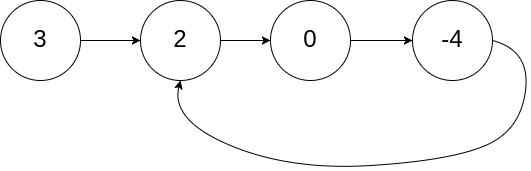
输入:head = [3,2,0,-4], pos = 1
输出:true
解释:链表中有一个环,其尾部连接到第二个节点。
核心思路#
采用快慢指针的方式,设置slow和fast指针:
初始化:slow=fast=head 循环:当slow,fast和fast.next均不为None时,令slow=slow.next,fast=fast.next.next,若slow=fast,则存在环形链表;若slow和fast中存在None,则不存在环形链表。
代码#
 1class Solution:
 2  def hasCycle(self, head: Optional[ListNode]) -> bool:
 3    if not head:
 4      return False
 5    slow, fast=head, head
 6    while slow and fast and fast.next:
 7      slow, fast=slow.next, fast.next.next
 8      if slow==fast:
 9        return True
10    return False
21. 合并两个有序链表#
题目描述#
将两个升序链表合并为一个新的升序链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的。
示例:
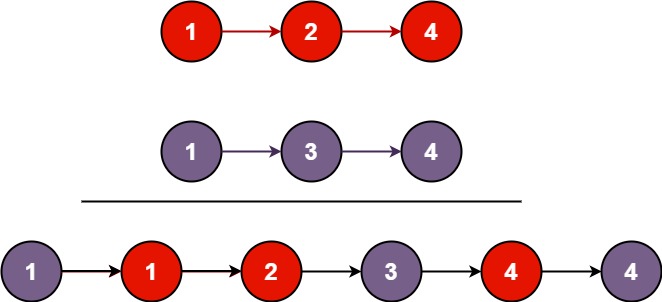
输入:l1 = [1,2,4], l2 = [1,3,4]
输出:[1,1,2,3,4,4]
核心思路#
- 创建哑节点:使用dummy作为合并后链表的头节点的前驱,简化头部处理。
- 初始化当前指针:用current指向当前合并链表的最后一个节点。
- 迭代合并:比较list1和list2的值,选择较小的节点接入合并链表,并移动相应的指针。
- 处理剩余部分:将未遍历完的链表直接接入合并链表的末尾。
- 返回结果:返回dummy.next,即合并后的链表头节点。
代码#
 1class Solution:
 2    def mergeTwoLists(self, list1: Optional[ListNode], list2: Optional[ListNode]) -> Optional[ListNode]:
 3        # 创建一个哑节点作为合并后链表的头节点的前驱节点
 4        dummy = ListNode(-1)
 5        current = dummy
 6
 7        # 当两个链表都不为空时,进行迭代合并
 8        while list1 and list2:
 9            if list1.val <= list2.val:
10                # 如果list1的值较小或相等,将其节点接入合并链表
11                current.next = list1
12                list1 = list1.next
13            else:
14                # 如果list2的值较小,将其节点接入合并链表
15                current.next = list2
16                list2 = list2.next
17            # 移动当前指针到合并链表的最后一个节点
18            current = current.next
19
20        # 将未遍历完的链表直接接入合并链表的末尾
21        current.next = list1 if list1 else list2
22
23        # 返回合并后的链表头节点
24        return dummy.next
142. 环形链表 II#
题目描述#
给定一个链表的头节点 head,返回链表开始入环的第一个节点。如果链表无环,则返回null。
如果链表中有某个节点,可以通过连续跟踪next指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数pos来表示链表尾连接到链表中的位置(索引从 0 开始)。如果pos是-1,则在该链表中没有环。注意:pos不作为参数进行传递,仅仅是为了标识链表的实际情况。
不允许修改链表。
示例:
输入:head = [3,2,0,-4], pos = 1
输出:返回索引为 1 的链表节点
解释:链表中有一个环,其尾部连接到第二个节点。
核心思路#
快慢指针用来检测链表中是否存在环。一旦快慢指针相遇,说明链表中存在环。接下来的关键是如何找到环的起始节点。
检测环:
- 使用两个指针slow和fast,slow每次移动一步,fast每次移动两步。
- 如果fast和slow相遇,则说明链表中存在环。
找到环的起始节点:
- 当fast和slow相遇时,将其中一个指针(例如slow)重置到链表的头部。
- 然后,两个指针都每次移动一步,直到它们再次相遇。这个相遇点就是环的起始节点。
原理:
假设链表的头部到环的起始节点的距离为a,环的长度为b。当slow和fast相遇时,slow走了a + b * k步,fast走了a + b * m步,其中m > k。因为fast的速度是slow的两倍,所以有: [ 2(a + b * k) = a + b * m ] 简化后得到: [ a = (m - 2k) * b ] 这说明a是环长度b的整数倍。因此,当slow从头开始,fast从相遇点开始,每次移动一步时,它们会在环的起始节点相遇。
代码#
 1class Solution:
 2    def detectCycle(self, head: Optional[ListNode]) -> Optional[ListNode]:
 3        if not head or not head.next:
 4            return None
 5
 6        slow = head
 7        fast = head
 8
 9        # 检测是否有环
10        while fast and fast.next:
11            slow = slow.next
12            fast = fast.next.next
13            if slow == fast:
14                break
15        else:
16            return None
17
18        # 找到环的起始节点
19        slow = head
20        while slow != fast:
21            slow = slow.next
22            fast = fast.next
23
24        return slow
2. 两数相加#
题目描述#
给你两个非空的链表,表示两个非负的整数。它们每位数字都是按照逆序的方式存储的,并且每个节点只能存储一位数字。
请你将两个数相加,并以相同形式返回一个表示和的链表。
你可以假设除了数字 0 之外,这两个数都不会以 0开头。
示例:
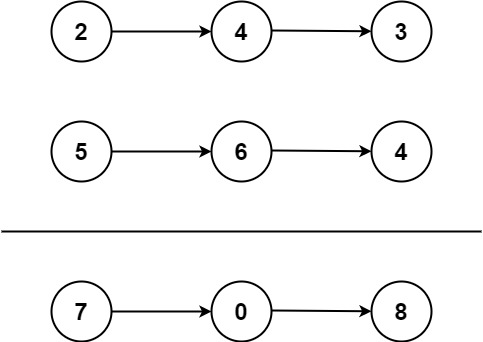
输入:l1 = [2,4,3], l2 = [5,6,4]
输出:[7,0,8]
解释:342 + 465 = 807
核心思路#
初始化结果链表和进位变量:
- 创建一个虚拟头节点 dummy,用于简化边界条件处理。
- 初始化进位变量 carry 为 0。
遍历两个链表:
- 使用两个指针 p1 和 p2 分别指向链表 L1 和 L2 的头节点。
- 创建一个指针 current 指向 dummy,用于构建结果链表。
逐位相加:
- 在 p1 或 p2 不为空时,执行以下操作:
- 计算当前位的和 sum = (p1.val if p1 else 0) + (p2.val if p2 else 0) + carry。
- 更新进位 carry = sum // 10。
- 创建一个新节点,节点值为 sum % 10,并将其连接到结果链表的末尾。
- 移动 current 指针到新节点。
- 如果 p1 不为空,移动 p1 指针到下一个节点。
- 如果 p2 不为空,移动 p2 指针到下一个节点。
- 在 p1 或 p2 不为空时,执行以下操作:
处理剩余的进位:
- 如果遍历完两个链表后,carry 仍不为 0,则在结果链表的末尾新增一个节点,节点值为 carry。
返回结果链表:
- 返回 dummy.next,即结果链表的头节点。
代码#
 1class Solution:
 2    def addTwoNumbers(self, l1: Optional[ListNode], l2: Optional[ListNode]) -> Optional[ListNode]:
 3        # 创建虚拟头节点,用于简化链表操作
 4        dummy = ListNode(0)
 5        current = dummy
 6        carry = 0
 7
 8        # 遍历两个链表,直到两者都为空
 9        while l1 or l2:
10            # 计算当前位的和,考虑进位
11            sum_val = (l1.val if l1 else 0) + (l2.val if l2 else 0) + carry
12            carry = sum_val // 10  # 更新进位
13            current.next = ListNode(sum_val % 10)  # 创建新节点,存储当前位的值
14            current = current.next  # 移动 current 指针到新节点
15
16            # 移动 l1 和 l2 指针到下一个节点
17            if l1:
18                l1 = l1.next
19            if l2:
20                l2 = l2.next
21
22        # 如果最后有进位,需要在结果链表的末尾新增一个节点
23        if carry > 0:
24            current.next = ListNode(carry)
25
26        # 返回结果链表的头节点,即虚拟头节点的下一个节点
27        return dummy.next
19. 删除链表的倒数第 N 个结点#
题目描述#
给你一个链表,删除链表的倒数第n个结点,并且返回链表的头结点。
示例:
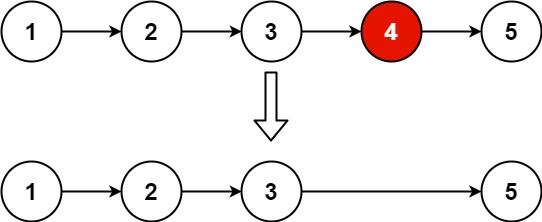
输入:head = [1,2,3,4,5], n = 2
输出:[1,2,3,5]
核心思路#
使用快慢指针解决删除链表的倒数第n个结点的问题是一个非常高效的方法。这里的关键在于如何让两个指针在链表中保持一定的距离,从而当一个指针到达链表末尾时,另一个指针正好指向需要删除的结点的前一个结点。
初始化指针:
- 创建一个虚拟头结点dummy,它的next指向原链表的头结点head。这样做可以简化边界条件的处理,尤其是当需要删除的结点是头结点时。
- 初始化两个指针fast和slow,都指向dummy。
移动快指针:
- 先移动fast指针n步。这样fast和slow之间的距离就是n。
同时移动两个指针:
- 当fast指针到达链表末尾时(即fast.next为None),slow指针正好指向需要删除的结点的前一个结点。
- 这是因为fast和slow之间的距离始终保持为n,所以当fast到达末尾时,slow就在倒数第n个结点的前一个位置。
删除结点:
- 修改slow的next指针,使其跳过需要删除的结点,即slow.next = slow.next.next。
返回结果:
- 返回dummy.next,即新的链表头结点。
代码#
 1class Solution:
 2    def removeNthFromEnd(self, head: Optional[ListNode], n: int) -> Optional[ListNode]:
 3        # 创建虚拟头结点,简化边界条件处理
 4        dummy = ListNode(0, head)
 5
 6        # 初始化快慢指针
 7        fast = slow = dummy
 8
 9        # 移动快指针 n 步
10        for _ in range(n):
11            fast = fast.next
12
13        # 同时移动两个指针,直到快指针到达链表末尾
14        while fast.next:
15            fast = fast.next
16            slow = slow.next
17
18        # 删除结点
19        slow.next = slow.next.next
20
21        # 返回新的头结点
22        return dummy.next
24. 两两交换链表中的节点#
题目描述#
给你一个链表,两两交换其中相邻的节点,并返回交换后链表的头节点。你必须在不修改节点内部的值的情况下完成本题(即,只能进行节点交换)。
示例:
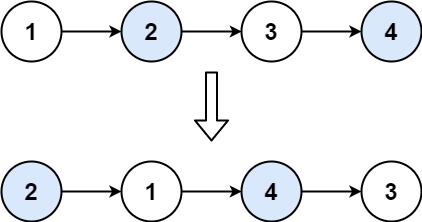
输入:head = [1,2,3,4]
输出:[2,1,4,3]
核心思路#
解决这个问题的一个有效方法是使用迭代,通过维护几个指针来交换链表中的节点。
创建一个虚拟头节点
- 为了简化边界情况的处理,可以在原链表的头部添加一个虚拟头节点(dummy node),这样可以方便地处理原链表头部的节点交换。
初始化指针
- prev指向虚拟头节点,用于记录当前需要交换的两个节点的前一个节点。
- current指向链表的头节点,即需要交换的第一个节点。
- next指向当前节点的下一个节点,即需要交换的第二个节点。
迭代交换节点 在循环中,每次交换两个相邻的节点,并更新指针:
- 将prev的next指向next(即第二个节点)。
- 将current的next指向next.next(即第二个节点的下一个节点)。
- 将next的next指向current(即将第二个节点的next指向第一个节点)。
- 更新prev和current指针,以便处理下一对节点。
返回新的头节点
- 当所有节点都交换完成后,返回虚拟头节点的next,即新的链表头节点。
代码#
 1class Solution:
 2    def swapPairs(self, head: Optional[ListNode]) -> Optional[ListNode]:
 3        # 创建虚拟头节点,方便处理链表头部的交换
 4        dummy = ListNode(0)
 5        dummy.next = head
 6        prev = dummy
 7
 8        while head and head.next:
 9            # 定义需要交换的两个节点
10            first = head
11            second = head.next
12
13            # 交换节点
14            # 1. 将 prev 的 next 指向 second
15            prev.next = second
16            # 2. 将 first 的 next 指向 second 的 next
17            first.next = second.next
18            # 3. 将 second 的 next 指向 first
19            second.next = first
20
21            # 更新指针,准备处理下一对节点
22            prev = first
23            head = first.next
24
25        # 返回新的链表头节点
26        return dummy.next
148. 排序链表#
题目描述#
给你链表的头结点head,请将其按升序排列并返回排序后的链表。
示例:
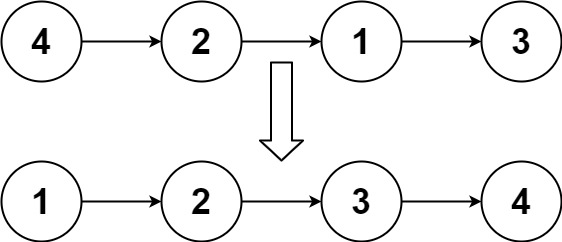
输入:head = [4,2,1,3]
输出:[1,2,3,4]
核心思路#
归并排序(Merge Sort)的时间复杂度为 O(nlog n),空间复杂度为 O(1)(如果使用自底向上的方法)。
- 找到链表的中间节点:使用快慢指针法,快指针每次移动两步,慢指针每次移动一步,当快指针到达链表末尾时,慢指针正好在中间。
- 分割链表:将链表从中间节点分成两个子链表。
- 递归排序:对两个子链表分别进行归并排序。
- 合并排序后的子链表:将两个有序的子链表合并成一个有序的链表。
代码#
 1class Solution:
 2    def sortList(self, head: Optional[ListNode]) -> Optional[ListNode]:
 3        if not head or not head.next:
 4            return head
 5
 6        # 找到链表的中间节点
 7        def find_mid(head: ListNode) -> ListNode:
 8            slow, fast = head, head.next
 9            while fast and fast.next:
10                slow = slow.next
11                fast = fast.next.next
12            return slow
13
14        # 合并两个有序链表
15        def merge(l1: ListNode, l2: ListNode) -> ListNode:
16            dummy = ListNode()
17            current = dummy
18            while l1 and l2:
19                if l1.val < l2.val:
20                    current.next = l1
21                    l1 = l1.next
22                else:
23                    current.next = l2
24                    l2 = l2.next
25                current = current.next
26            if l1:
27                current.next = l1
28            if l2:
29                current.next = l2
30            return dummy.next
31
32        # 找到中间节点并分割链表
33        mid = find_mid(head)
34        right = mid.next
35        mid.next = None
36        left = head
37
38        # 递归排序
39        left = self.sortList(left)
40        right = self.sortList(right)
41
42        # 合并排序后的子链表
43        return merge(left, right)
146. LRU 缓存#
题目描述#
请你设计并实现一个满足LRU (最近最少使用) 缓存约束的数据结构。
实现LRUCache类:
LRUCache(int capacity)以正整数作为容量capacity初始化 LRU 缓存int get(int key)如果关键字key存在于缓存中,则返回关键字的值,否则返回-1。void put(int key, int value)如果关键字key已经存在,则变更其数据值value;如果不存在,则向缓存中插入该组key-value。如果插入操作导致关键字数量超过capacity,则应该逐出最久未使用的关键字。
函数get和put必须以O(1)的平均时间复杂度运行。
示例:
输入
["LRUCache", "put", "put", "get", "put", "get", "put", "get", "get", "get"]
[[2], [1, 1], [2, 2], [1], [3, 3], [2], [4, 4], [1], [3], [4]]

输出
[null, null, null, 1, null, -1, null, -1, 3, 4]

解释
LRUCache lRUCache = new LRUCache(2);
lRUCache.put(1, 1); // 缓存是 {1=1}
lRUCache.put(2, 2); // 缓存是 {1=1, 2=2}
lRUCache.get(1);    // 返回 1
lRUCache.put(3, 3); // 该操作会使得关键字 2 作废,缓存是 {1=1, 3=3}
lRUCache.get(2);    // 返回 -1 (未找到)
lRUCache.put(4, 4); // 该操作会使得关键字 1 作废,缓存是 {4=4, 3=3}
lRUCache.get(1);    // 返回 -1 (未找到)
lRUCache.get(3);    // 返回 3
lRUCache.get(4);    // 返回 4
核心思路#
LRU(最近最少使用)缓存是一种常见的缓存策略,用于管理有限的内存资源。当缓存满时,它会优先淘汰最近最少使用的数据项。这个题目要求你设计一个数据结构来实现 LRUCache 类,该类需要支持get和put操作,并且这些操作的时间复杂度都是 O(1)。
双向链表 + 哈希表
- 双向链表:用于维护缓存中的键值对顺序,最近使用的节点放在链表的头部,最久未使用的节点放在链表的尾部。
- 哈希表:用于快速查找节点,哈希表的键是缓存的键,值是对应的链表节点。
操作细节
- get操作:
- 如果键存在,返回对应的值,并将该节点移动到链表的头部(表示最近使用)。
- 如果键不存在,返回 -1。
- put操作:
- 如果键已存在,更新其值,并将该节点移动到链表的头部。
- 如果键不存在,插入新的键值对到链表的头部。
- 如果插入后缓存超过容量,移除链表尾部的节点(最久未使用的节点)。
- get操作:
代码#
 1class LRUCache:
 2    def __init__(self, capacity: int):
 3        # 使用 OrderedDict 来维护键值对的顺序
 4        self.data = OrderedDict()
 5        # 初始化缓存的容量
 6        self.capacity = capacity
 7
 8    def get(self, key: int) -> int:
 9        # 如果键存在于缓存中
10        if key in self.data:
11            # 将该键值对移动到有序字典的末尾(表示最近使用)
12            self.data.move_to_end(key)
13            # 返回对应的值
14            return self.data[key]
15        # 如果键不存在于缓存中,返回 -1
16        return -1
17
18    def put(self, key: int, value: int) -> None:
19        # 如果键已经存在于缓存中
20        if key in self.data:
21            # 更新该键的值
22            self.data[key] = value
23        else:
24            # 如果缓存已满
25            if len(self.data) >= self.capacity:
26                # 移除最久未使用的键值对(有序字典的头部)
27                self.data.popitem(last=False)
28            # 插入新的键值对
29            self.data[key] = value
30        # 将该键值对移动到有序字典的末尾(表示最近使用)
31        self.data.move_to_end(key)
138. 随机链表的复制#
题目描述#
给你一个长度为n的链表,每个节点包含一个额外增加的随机指针random,该指针可以指向链表中的任何节点或空节点。
构造这个链表的深拷贝。深拷贝应该正好由n个全新节点组成,其中每个新节点的值都设为其对应的原节点的值。新节点的next指针和random指针也都应指向复制链表中的新节点,并使原链表和复制链表中的这些指针能够表示相同的链表状态。复制链表中的指针都不应指向原链表中的节点。
例如,如果原链表中有X和Y两个节点,其中X.random --> Y。那么在复制链表中对应的两个节点x和y,同样有x.random --> y。
返回复制链表的头节点。
用一个由n个节点组成的链表来表示输入/输出中的链表。每个节点用一个[val, random_index]表示:
val:一个表示Node.val的整数。random_index:随机指针指向的节点索引(范围从0到n-1);如果不指向任何节点,则为null。
你的代码只接受原链表的头节点head作为传入参数。
示例:
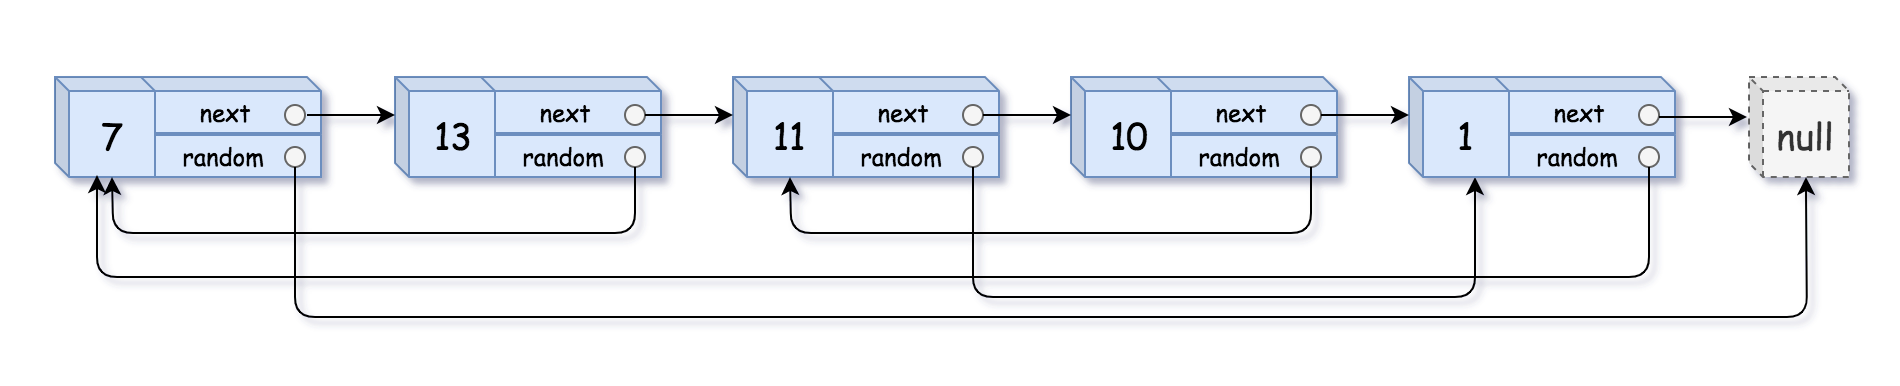
输入:head = [[7,null],[13,0],[11,4],[10,2],[1,0]]
输出:[[7,null],[13,0],[11,4],[10,2],[1,0]]
核心思路#
复制每个节点并插入到原节点后面:
- 首先遍历原链表,对于每个节点,创建一个新的节点,并将其插入到当前节点和下一个节点之间。这样,原链表A -> B -> C变成A -> A’ -> B -> B’ -> C -> C’,其中A’,B’,C’是新复制的节点。
设置新节点的随机指针:
- 再次遍历链表,这次设置每个新节点的random指针。由于新节点紧跟在原节点后面,原节点的random指针指向的节点后面就是新节点的random指针应该指向的节点。例如,如果原节点A的random指针指向B,那么新节点A’的random指针应该指向B’。
分离两个链表:
- 最后,我们需要将原链表和新链表分开。遍历链表,将新节点从原链表中分离出来,恢复原链表的结构,同时构建新链表。
代码#
 1class Solution:
 2    def copyRandomList(self, head: 'Optional[Node]') -> 'Optional[Node]':
 3        if not head:
 4            return None
 5
 6        # Step 1: 创建新节点并插入到原节点后面
 7        curr = head
 8        while curr:
 9            # 创建新节点,并将其值设为当前节点的值
10            new_node = Node(curr.val, curr.next, None)
11            # 将新节点插入到当前节点和下一个节点之间
12            curr.next = new_node
13            # 移动到下一个原节点
14            curr = new_node.next
15
16        # Step 2: 设置新节点的随机指针
17        curr = head
18        while curr:
19            # 如果当前节点有随机指针
20            if curr.random:
21                # 新节点的随机指针应该指向原节点随机指针对应的新节点
22                curr.next.random = curr.random.next
23            # 移动到下一个原节点
24            curr = curr.next.next
25
26        # Step 3: 分离两个链表
27        old_head = head
28        new_head = head.next
29        curr_old = old_head
30        curr_new = new_head
31
32        while curr_old:
33            # 恢复原链表的结构
34            curr_old.next = curr_old.next.next if curr_old.next else None
35            # 构建新链表的结构
36            curr_new.next = curr_new.next.next if curr_new.next else None
37            # 移动到下一个原节点
38            curr_old = curr_old.next
39            # 移动到新链表的下一个新节点
40            curr_new = curr_new.next
41
42        return new_head
二叉树#
94. 二叉树的中序遍历#
题目描述#
给定一个二叉树的根节点root,返回_它的中序遍历_。
示例:
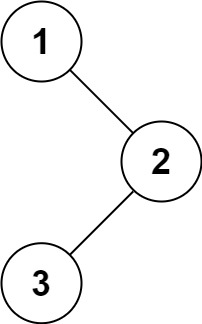
输入:root = [1,null,2,3]
输出:[1,3,2]
核心思路#
【方法一:递归】 中序遍历的顺序是先遍历左子树,然后访问根节点,最后遍历右子树。
主方法:
- 初始化一个空列表 result 用于存储遍历结果。
- 调用递归辅助方法 inorder,传入根节点和结果列表。
- 返回结果列表。
递归辅助方法 inorder:
- 检查当前节点是否为空,如果为空则返回。
- 递归遍历当前节点的左子树。
- 将当前节点的值添加到结果列表中。
- 递归遍历当前节点的右子树。
- 返回结果列表。 【方法二:栈】
初始化一个栈和一个结果列表。
使用一个循环,只要当前节点或栈不为空,就继续遍历。
在循环中,将当前节点的所有左子节点压入栈中,直到没有左子节点为止。
弹出栈顶节点,访问该节点并将它的值加入结果列表。
将当前节点更新为刚访问节点的右子节点,继续遍历右子树。
代码#
【方法一:递归】
 1class Solution:
 2    def inorderTraversal(self, root: Optional[TreeNode]) -> List[int]:
 3        result = []  # 初始化一个空列表来存储遍历结果
 4        self.inorder(root, result)  # 调用辅助递归函数进行中序遍历
 5        return result  # 返回遍历结果列表
 6
 7    def inorder(self, root, result):
 8        if not root:  # 如果当前节点为空,直接返回
 9            return
10        self.inorder(root.left, result)  # 递归遍历左子树
11        result.append(root.val)  # 将当前节点的值加入结果列表
12        self.inorder(root.right, result)  # 递归遍历右子树
13        return result  # 返回结果列表(虽然这个返回值在主方法中没有用到)
【方法二:栈】
 1class Solution:
 2    def inorderTraversal(self, root: Optional[TreeNode]) -> List[int]:
 3        stack, result = [], []  # 初始化栈和结果列表
 4
 5        while root or stack:  # 当根节点不为空或栈不为空时循环
 6            while root:  # 遍历到当前子树的最左节点
 7                stack.append(root)  # 将当前节点入栈
 8                root = root.left  # 移动到左子节点
 9
10            root = stack.pop()  # 弹出栈顶节点(最左节点)
11            result.append(root.val)  # 将弹出节点的值加入结果列表
12            root = root.right  # 移动到右子节点
13
14        return result  # 返回结果列表
104. 二叉树的最大深度#
题目描述#
给定一个二叉树root,返回其最大深度。
二叉树的最大深度是指从根节点到最远叶子节点的最长路径上的节点数。
示例:
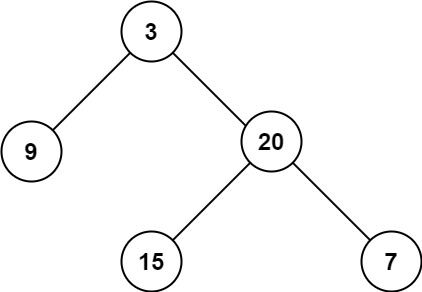
输入:root = [3,9,20,null,null,15,7]
输出:3
核心思路#
【方法一:递归】 终止条件:如果当前节点(root)为空,说明我们已经到达了树的末端,这时候返回高度为0。 递归拆解:对每个节点,二叉树的最大深度等于其左子树和右子树中较大的那个深度再加上1。
【方法二:层序遍历】 初始检查:如果根节点为空,则直接返回深度0。 初始化:使用一个队列来进行广度优先搜索(BFS),将根节点放入队列,并初始化最大深度为1。 BFS遍历:
- 每次从队列中取出当前层的所有节点,检查它们的左子节点和右子节点,如果存在则加入队列。
- 每处理完一层后,增加最大深度计数器。 结束条件:当队列为空时,表示已遍历完所有节点,返回最大深度。
代码#
【方法一:递归】
1class Solution:
2    def maxDepth(self, root: Optional[TreeNode]) -> int:
3        if not root:
4            return 0
5        return max(self.maxDepth(root.left)+1,self.maxDepth(root.right)+1)
【方法二:广度优先搜索】
 1class Solution:
 2    # 使用广度优先搜索 (BFS) 计算最大深度
 3    def maxDepth(self, root: Optional[TreeNode]) -> int:
 4        if not root:
 5            return 0  # 空树的深度为0
 6
 7        maxDepth = 1  # 初始最大深度为1(至少有根节点)
 8        queue = deque()  # 创建一个队列来进行BFS遍历
 9        queue.append(root)  # 将根节点添加到队列中
10
11        while len(queue):  # 当队列不为空时,继续遍历
12            length = len(queue)  # 获取当前层的节点数量
13            for i in range(length):
14                head = queue.popleft()  # 弹出当前层的第一个节点
15                if head.left is not None:  # 如果左子节点存在,加入队列
16                    queue.append(head.left)
17                if head.right is not None:  # 如果右子节点存在,加入队列
18                    queue.append(head.right)
19            if len(queue) == 0:  # 如果队列为空,说明已遍历完所有节点
20                break
21            maxDepth += 1  # 每处理完一层,最大深度加1
22
23        return maxDepth  # 返回最终的最大深度
226. 翻转二叉树#
题目描述#
给你一棵二叉树的根节点root,翻转这棵二叉树,并返回其根节点。
示例:
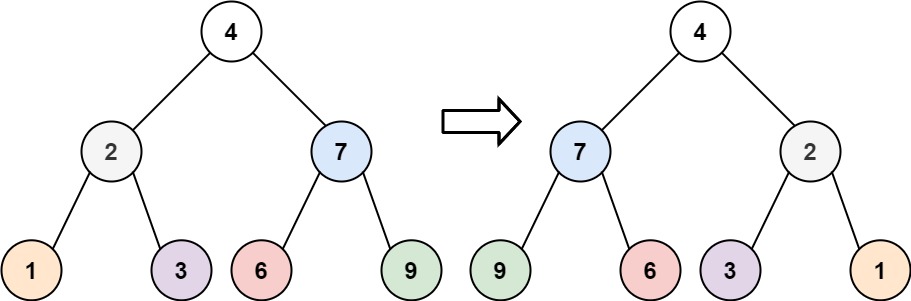
输入:root = [4,2,7,1,3,6,9]
输出:[4,7,2,9,6,3,1]
核心思路#
【方法一:DFS(递归)】
- 检查根节点是否为空:如果根节点为空,则直接返回,因为空树不需要翻转。
- 递归翻转左右子树:递归调用翻转函数,先翻转左子树,再翻转右子树。确保每棵子树都被正确翻转。
- 交换左右子节点:在递归处理完左右子树之后,将当前节点的左子节点和右子节点进行交换。
- 返回翻转后的根节点:最后返回翻转后的根节点,以保证整棵树从上到下都是翻转后的结构。
【方法二:BFS(队列)】
构造队列queue,对于root根节点,若root为空,则直接返回root;若root不为空,则将其入队。
在队列不为空时,开始循环弹出队列队首元素。head=queue.pop()。然后交换head 的左右节点,若head的左右节点不为空,则将其入队。
最后,返回root。
代码#
【方法一:DFS(递归)】
 1class Solution:
 2    def invertTree(self, root: Optional[TreeNode]) -> Optional[TreeNode]:
 3        def exchange(root):
 4            if not root:
 5                return
 6            root.left,root.right=root.right,root.left
 7            exchange(root.left)
 8            exchange(root.right)
 9        exchange(root)
10        return root
【方法二:BFS(队列)】
 1class Solution:
 2    def invertTree(self, root: Optional[TreeNode]) -> Optional[TreeNode]:
 3        if not root:
 4            return root
 5        # 初始化队列并将根节点入队
 6        queue = deque([root])
 7        # 当队列不为空时,进行广度优先遍历
 8        while queue:
 9            # 弹出队首元素
10            head = queue.popleft()
11            # 交换左右子节点
12            head.left, head.right = head.right, head.left
13            # 将非空的左右子节点分别入队
14            if head.left:
15                queue.append(head.left)
16            if head.right:
17                queue.append(head.right)
18        # 返回反转后的树的根节点
19        return root
543. 二叉树的直径#
题目描述#
给你一棵二叉树的根节点,返回该树的直径。
二叉树的直径是指树中任意两个节点之间最长路径的长度。这条路径可能经过也可能不经过根节点root。
两节点之间路径的长度由它们之间边数表示。
示例:
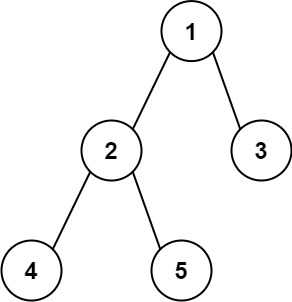
输入:root = [1,2,3,4,5]
输出:3
解释:3 ,取路径 [4,2,1,3] 或 [5,2,1,3] 的长度。
核心思路#
- 在每个节点计算通过该节点的左子树深度和右子树深度。
- 计算通过该节点的路径长度(左子树深度 + 右子树深度)。
- 更新全局最大直径。
- 返回当前节点的深度(即 max(左子树深度, 右子树深度) + 1)。
代码#
 1class Solution:
 2    def diameterOfBinaryTree(self, root: Optional[TreeNode]) -> int:
 3        maxDiameter = 0
 4
 5        def depth(node: TreeNode) -> int:
 6            nonlocal maxDiameter
 7            if not node:
 8                return 0
 9            leftDepth = depth(node.left)
10            rightDepth = depth(node.right)
11            # 更新最大直径
12            maxDiameter = max(maxDiameter, leftDepth + rightDepth)
13
14            # 返回该节点的深度
15            return max(leftDepth, rightDepth) + 1
16
17        depth(root)
18        return maxDiameter
108. 将有序数组转换为二叉搜索树#
题目描述#
给你一个整数数组nums,其中元素已经按升序排列,请你将其转换为一棵平衡 二叉搜索树。
平衡二叉树是一种特殊的二叉搜索树,其中任意节点的左右子树高度差不超过1。它可以保证在最坏情况下的查找、插入和删除操作的时间复杂度都是 O(log n) 级别。 平衡二叉树常用的实现方式有红黑树、AVL树、Treap等。
示例:
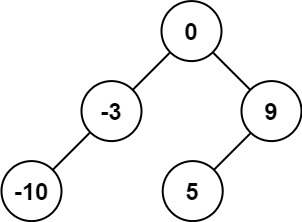
输入:nums = [-10,-3,0,5,9]
输出:[0,-3,9,-10,null,5]
解释:[0,-10,5,null,-3,null,9] 也将被视为正确答案
核心思路#
- 选择中间元素作为根节点:升序数组的中间元素自然地成为根节点,因为它可以将数组分成两部分,左边部分的所有元素都小于它,右边部分的所有元素都大于它。
- 递归构建左右子树:
- 对于根节点的左子树,从数组的开始位置到中间位置-1的部分,递归执行相同的过程。
- 对于根节点的右子树,从中间位置+1到数组的结束位置的部分,递归执行相同的过程。
- 停止条件:当子数组为空时,返回None。
代码#
 1class Solution:
 2    def sortedArrayToBST(self, nums: List[int]) -> Optional[TreeNode]:
 3        """
 4        将排序数组转换为高度平衡的二叉搜索树。
 5
 6        :param nums: 排序数组
 7        :return: 二叉搜索树的根节点
 8        """
 9        def helper(left: int, right: int) -> Optional[TreeNode]:
10            """
11            辅助函数,递归地将子数组转换为BST。
12
13            :param left: 子数组的左边界
14            :param right: 子数组的右边界
15            :return: 当前子数组对应的BST的根节点
16            """
17            if left > right:
18                return None  # 如果左边界大于右边界,返回None,表示当前子数组为空
19
20            # 选择中间元素作为根节点
21            mid = (left + right) // 2
22            root = TreeNode(nums[mid])
23
24            # 递归构建左子树和右子树
25            root.left = helper(left, mid - 1)
26            root.right = helper(mid + 1, right)
27
28            return root
29
30        # 从整个数组开始递归构建BST
31        return helper(0, len(nums) - 1)
102. 二叉树的层序遍历#
题目描述#
给你二叉树的根节点root,返回其节点值的层序遍历。 (即逐层地,从左到右访问所有节点)。
示例:
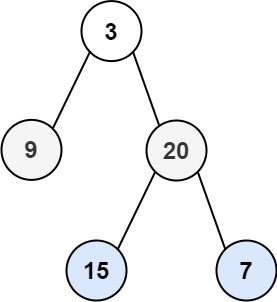
输入:root = [3,9,20,null,null,15,7]
输出:[[3],[9,20],[15,7]]
核心思路#
初始化:
- 创建一个结果列表result,用于存储每一层的节点值。
- 创建一个双端队列queue,并将根节点加入队列。
遍历队列:
- 当队列不为空时,进行以下步骤:
- 记录当前层的节点数level_size。
- 创建一个空列表current_level,用于存储当前层的节点值。
- 遍历当前层的所有节点:
- 从队列中取出一个节点node。
- 将node的值加入current_level。
- 如果node有左子节点,将左子节点加入队列。
- 如果node有右子节点,将右子节点加入队列。
- 将current_level加入result。
- 当队列不为空时,进行以下步骤:
返回结果:
- 遍历结束后,返回result。
代码#
 1class Solution:
 2    def levelOrder(self, root: Optional[TreeNode]) -> List[List[int]]:
 3        if not root:
 4            return []  # 如果根节点为空,直接返回空列表
 5
 6        result = []  # 用于存储最终的层序遍历结果
 7        queue = deque([root])  # 初始化队列,将根节点加入队列
 8
 9        while queue:
10            level_size = len(queue)  # 记录当前层的节点数
11            current_level = []  # 用于存储当前层的节点值
12
13            for _ in range(level_size):
14                node = queue.popleft()  # 从队列中取出一个节点
15                current_level.append(node.val)  # 将节点值加入当前层的列表
16
17                if node.left:
18                    queue.append(node.left)  # 如果节点有左子节点,将左子节点加入队列
19                if node.right:
20                    queue.append(node.right)  # 如果节点有右子节点,将右子节点加入队列
21
22            result.append(current_level)  # 将当前层的节点值列表加入结果列表
23
24        return result  # 返回最终的层序遍历结果
98. 验证二叉搜索树#
题目描述#
给你一个二叉树的根节点root,判断其是否是一个有效的二叉搜索树。
有效二叉搜索树定义如下:
- 节点的左子树只包含小于当前节点的数。
- 节点的右子树只包含大于当前节点的数。
- 所有左子树和右子树自身必须也是二叉搜索树。
示例:

输入:root = [2,1,3]
输出:true
核心思路#
验证一个二叉树是否为二叉搜索树(BST)的关键在于确保每个节点的值都在一个特定的范围内。具体来说: - 对于每个节点,其左子树的所有节点值必须小于该节点的值。 - 对于每个节点,其右子树的所有节点值必须大于该节点的值。
可以通过递归的方法来实现这一点,同时传递一个范围给每个递归调用,确保当前节点的值在这个范围内。
定义一个辅助函数:
- isValidBST,它接受三个参数:当前节点node、当前节点值的下限min_val和上限max_val。
递归终止条件:
- 如果当前节点为空,返回True,因为空树是有效的BST。
- 如果当前节点的值不在min_val和max_val之间,返回False。
递归调用:
- 递归检查左子树,左子树的值必须小于当前节点的值,所以传递min_val和node.val作为新的范围。
- 递归检查右子树,右子树的值必须大于当前节点的值,所以传递node.val和max_val作为新的范围。
返回结果:只有当左右子树都是有效的BST时,当前节点才是有效的BST。
代码#
 1class Solution:
 2	def isValidBST(root: TreeNode) -> bool:
 3	    def helper(node, min_val=float('-inf'), max_val=float('inf')):
 4	        # 如果当前节点为空,返回 True,因为空树是有效的BST
 5	        if not node:
 6	            return True
 7
 8	        # 检查当前节点的值是否在指定的范围内
 9	        if not (min_val < node.val < max_val):
10	            return False
11
12	        # 递归检查左子树
13	        # 左子树的所有节点值必须小于当前节点的值
14	        left_valid = helper(node.left, min_val, node.val)
15
16	        # 递归检查右子树
17	        # 右子树的所有节点值必须大于当前节点的值
18	        right_valid = helper(node.right, node.val, max_val)
19
20	        # 只有当左右子树都满足条件时,当前节点才是有效的BST
21	        return left_valid and right_valid
22
23	    # 初始调用,范围是负无穷到正无穷
24	    return helper(root)
230. 二叉搜索树中第 K 小的元素#
题目描述#
给定一个二叉搜索树的根节点root,和一个整数k,请你设计一个算法查找其中第k小的元素(从 1 开始计数)。
示例:
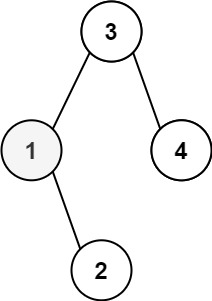
输入:root = [3,1,4,null,2], k = 1
输出:1
核心思路#
在二叉搜索树(BST)中,左子树的所有节点值都小于根节点的值,右子树的所有节点值都大于根节点的值。利用这一性质,可以通过中序遍历来按升序访问所有节点。
- 中序遍历:中序遍历二叉搜索树会得到一个有序列表(从小到大)。
- 提前终止:在遍历到第 k 个节点时,可以直接返回该节点的值,而不需要遍历完整棵树。
代码#
 1class Solution:
 2    def kthSmallest(self, root: Optional[TreeNode], k: int) -> int:
 3        stack = []
 4        current = root
 5
 6        while current or stack:
 7            # 先遍历左子树,将所有左子节点压入栈中
 8            while current:
 9                stack.append(current)
10                current = current.left
11
12            # 从栈中弹出一个节点,访问该节点
13            current = stack.pop()
14            k -= 1  # 每访问一个节点,k 减 1
15
16            # 如果 k 为 0,说明当前节点是第 k 小的元素,直接返回
17            if k == 0:
18                return current.val
19
20            # 继续遍历右子树
21            current = current.right
199. 二叉树的右视图#
题目描述#
给定一个二叉树的根节点root,想象自己站在它的右侧,按照从顶部到底部的顺序,返回从右侧所能看到的节点值。
示例:

输入:[1,2,3,null,5,null,4]
输出:[1,3,4]
核心思路#
我们需要逐层遍历二叉树,记录每层最右侧的节点,在每一层中,我们只关心最右侧的节点。
初始化:
- 创建一个队列,将根节点加入队列。
- 创建一个结果列表,用于存储从右侧看到的节点值。
层次遍历:
- 使用一个while循环,只要队列不为空,就继续处理。
- 在每次循环开始时,记录当前队列的长度,这个长度表示当前层的节点数。
处理当前层:
- 使用一个for循环,遍历当前层的所有节点。
- 在每次迭代中,从队列中取出一个节点。
- 如果是当前层的最后一个节点,将其值加入结果列表。
- 将当前节点的左子节点和右子节点依次加入队列。
返回结果:
- 最终,结果列表中存储的就是从右侧看到的节点值。
代码#
 1class Solution:
 2    def rightSideView(self, root: Optional[TreeNode]) -> List[int]:
 3        if not root:
 4            return []  # 如果根节点为空,返回空列表
 5
 6        result = []  # 用于存储从右侧看到的节点值
 7        queue = deque([root])  # 初始化队列,将根节点加入队列
 8
 9        while queue:
10            # 当前层的节点数
11            level_length = len(queue)
12
13            for i in range(level_length):
14                # 从队列中取出一个节点
15                node = queue.popleft()
16
17                # 如果是当前层的最后一个节点,将其值加入结果列表
18                if i == level_length - 1:
19                    result.append(node.val)
20
21                # 将当前节点的子节点加入队列
22                if node.left:
23                    queue.append(node.left)
24                if node.right:
25                    queue.append(node.right)
26
27        return result  # 返回从右侧看到的节点值
114. 二叉树展开为链表#
题目描述#
给你二叉树的根结点root,请你将它展开为一个单链表:
- 展开后的单链表应该同样使用
TreeNode,其中right子指针指向链表中下一个结点,而左子指针始终为null。 - 展开后的单链表应该与二叉树先序遍历顺序相同。
示例:
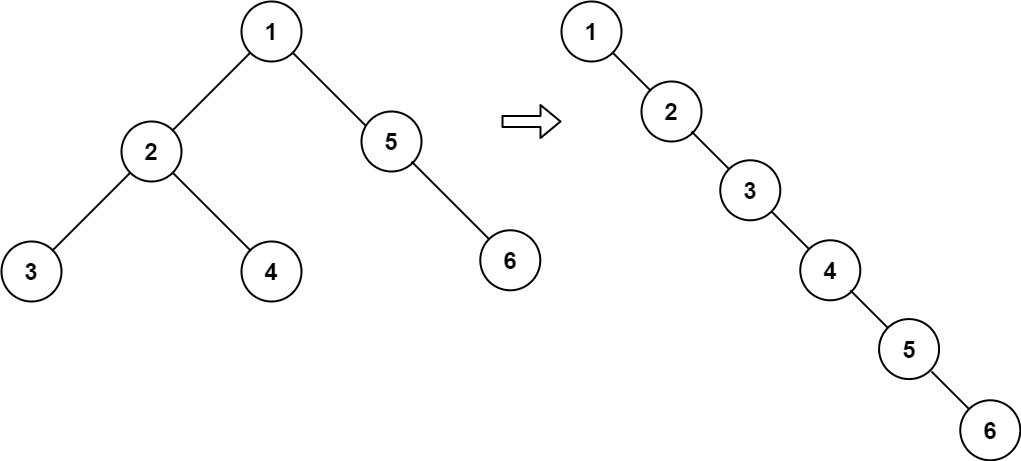
输入:root = [1,2,5,3,4,null,6]
输出:[1,null,2,null,3,null,4,null,5,null,6]
核心思路#
将二叉树展开为单链表的问题可以通过递归或迭代的方法来解决。最优的解题思路通常是利用后序遍历的思想,因为我们需要先处理子节点再处理父节点。
- 后序遍历:由于我们需要先处理子节点再处理父节点,所以使用后序遍历(左-右-根)的思想。
- 调整指针:在遍历过程中,将当前节点的右子树接到左子树的最右节点的右子树上,然后将左子树变为右子树,左子树置为空。
- 递归调用:对每个节点都进行上述操作,直到遍历完整棵树。
代码#
 1class Solution:
 2    def flatten(self, root: Optional[TreeNode]) -> None:
 3        if not root:
 4            return
 5
 6        # 先递归展开左右子树
 7        self.flatten(root.left)
 8        self.flatten(root.right)
 9
10        # 如果有左子树
11        if root.left:
12            # 保存当前的右子树
13            right_subtree = root.right
14
15            # 将左子树移动到右子树的位置
16            root.right = root.left
17            root.left = None  # 清空左子树
18
19            # 找到右子树的最右节点
20            current = root
21            while current.right:
22                current = current.right
23
24            # 将保存的原右子树接到最右节点
25            current.right = right_subtree
105. 从前序与中序遍历序列构造二叉树#
题目描述#
给定两个整数数组preorder和inorder,其中preorder是二叉树的先序遍历,inorder是同一棵树的中序遍历,请构造二叉树并返回其根节点。
示例:
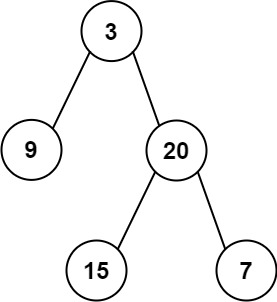
输入:preorder = [3,9,20,15,7], inorder = [9,3,15,20,7]
输出:[3,9,20,null,null,15,7]
核心思路#
理解先序和中序遍历的特点: - 先序遍历的第一个元素是树的根节点。 - 中序遍历中,根节点左边的部分是左子树,右边的部分是右子树。
递归构建二叉树: - 使用先序遍历的第一个元素创建根节点。 - 在中序遍历中找到这个根节点的位置,这样可以确定左子树和右子树的范围。 - 递归地构建左子树和右子树。
具体实现:
- 定义一个递归函数buildTree,该函数接受先序遍历和中序遍历的子数组范围作为参数。
- 在每次递归调用中,使用先序遍历的第一个元素创建根节点,并在中序遍历中找到该根节点的位置。
- 根据根节点的位置,划分出左子树和右子树的范围,并递归构建左子树和右子树。
代码#
 1class Solution:
 2    def buildTree(self, preorder: List[int], inorder: List[int]) -> Optional[TreeNode]:
 3        # 如果输入的先序或中序遍历为空,则返回 None
 4        if not preorder or not inorder:
 5            return None
 6
 7        # 先序遍历的第一个元素是根节点
 8        root_val = preorder[0]
 9        root = TreeNode(root_val)
10
11        # 在中序遍历中找到根节点的位置
12        root_index = inorder.index(root_val)
13
14        # 递归构建左子树
15        # 先序遍历中,根节点后的前 `root_index` 个元素是左子树的先序遍历
16        # 中序遍历中,根节点前的 `root_index` 个元素是左子树的中序遍历
17        root.left = self.buildTree(preorder[1:1 + root_index], inorder[:root_index])
18
19        # 递归构建右子树
20        # 先序遍历中,从 `1 + root_index` 到末尾的元素是右子树的先序遍历
21        # 中序遍历中,从 `root_index + 1` 到末尾的元素是右子树的中序遍历
22        root.right = self.buildTree(preorder[1 + root_index:], inorder[root_index + 1:])
23
24        # 返回构建的根节点
25        return root
437. 路径总和 III#
题目描述#
给定一个二叉树的根节点root,和一个整数targetSum,求该二叉树里节点值之和等于targetSum的路径的数目。
路径不需要从根节点开始,也不需要在叶子节点结束,但是路径方向必须是向下的(只能从父节点到子节点)。
示例:
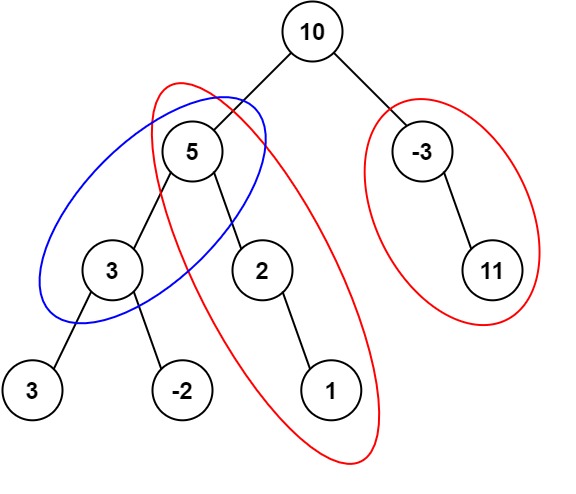
输入:root = [10,5,-3,3,2,null,11,3,-2,null,1], targetSum = 8
输出:3
解释:和等于 8 的路径有 3 条,如图所示。
核心思路#
这个问题可以使用递归结合前缀和的方式来求解。下面是详细步骤:
前缀和的概念:
- 前缀和是指从树的根节点到当前节点的路径上的所有节点的值之和。
- 我们使用一个哈希表(字典)来记录遍历过程中所有前缀和出现的次数。通过计算前缀和,我们可以快速查找某段路径的和是否等于 targetSum。
核心思路:
- 遍历树时,我们要检查以当前节点为终点,有没有一条路径的和等于 targetSum。
- 我们可以通过计算当前路径和 currSum,再检查哈希表中是否有一个前缀和(即 currSum - targetSum)存在。
- 如果存在,说明从该前缀和之后的部分路径,其和就是 targetSum。
具体步骤
- 用一个递归函数遍历二叉树,每到一个节点:
- 计算当前节点到根节点的路径和 currSum。
- 在哈希表中查找是否有 currSum - targetSum 的前缀和,存在说明从某段路径和等于 targetSum。
- 将当前路径和 currSum 加入哈希表,并将其出现次数增加1。
- 递归地遍历该节点的左子树和右子树。
- 返回时,将哈希表中当前路径和 currSum 的计数减1,避免影响其他路径。
- 用一个递归函数遍历二叉树,每到一个节点:
代码#
 1class Solution:
 2    def pathSum(self, root: Optional[TreeNode], targetSum: int) -> int:
 3        def dfs(node, currSum):
 4            if not node:
 5                return 0
 6
 7            # 更新当前路径和
 8            currSum += node.val
 9
10            # 计算从某个祖先节点到当前节点的路径和是否等于 targetSum
11            # 即 (currSum - targetSum) 是否在 prefix_sum_count 中存在
12            count = prefix_sum_count.get(currSum - targetSum, 0)
13
14            # 更新前缀和字典,记录当前路径和出现的次数
15            prefix_sum_count[currSum] = prefix_sum_count.get(currSum, 0) + 1
16
17            # 递归遍历左子树和右子树
18            count += dfs(node.left, currSum)
19            count += dfs(node.right, currSum)
20
21            # 回溯:移除当前节点对应的路径和,以便不影响其他分支的路径计数
22            prefix_sum_count[currSum] -= 1
23
24            return count
25
26        # 前缀和哈希表,记录每个路径和出现的次数
27        # 初始值为 {0: 1},表示从根节点到当前节点的路径和为0的路径有一条(即空路径)
28        prefix_sum_count = {0: 1}
29
30        return dfs(root, 0)
236. 二叉树的最近公共祖先#
题目描述#
给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。
百度百科中最近公共祖先的定义为:“对于有根树 T 的两个节点 p、q,最近公共祖先表示为一个节点 x,满足 x 是 p、q 的祖先且 x 的深度尽可能大(一个节点也可以是它自己的祖先)。”
示例 1:
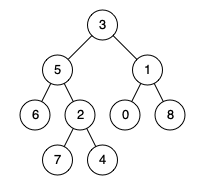
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 1
输出:3
解释:节点 5 和节点 1 的最近公共祖先是节点 3 。
核心思路#
要找到二叉树中节点 p 和 q 的最近公共祖先(LCA)。有几个关键点: 1. 如果当前节点是 p 或 q,那么它就是一个祖先节点。 2. 如果 p 和 q 分别位于当前节点的左右子树,那么当前节点就是它们的最近公共祖先。 3. 如果两个节点都位于左子树或都位于右子树,则继续在对应子树中寻找。
递归基:
- 如果当前节点是 None,直接返回 None;如果当前节点是 p 或 q,直接返回当前节点。
递归查找左右子树:
- 在左子树和右子树递归查找 p 和 q。
返回结果:
- 如果左右子树都找到值,说明 p 和 q 分别在左右子树,当前节点是最近公共祖先。
- 如果只有左子树找到结果,返回左子树结果。
- 如果只有右子树找到结果,返回右子树结果。
代码#
 1class Solution:
 2    def lowestCommonAncestor(self, root: 'TreeNode', p: 'TreeNode', q: 'TreeNode') -> 'TreeNode':
 3
 4        # 如果当前节点为空,说明已经到达叶子节点的底部,返回 None
 5        # 如果当前节点是 p 或 q,说明我们找到了其中一个节点,返回当前节点
 6        if not root or root == p or root == q:
 7            return root
 8
 9        # 在左子树中递归查找 p 和 q,返回在左子树中的结果
10        left = self.lowestCommonAncestor(root.left, p, q)
11
12        # 在右子树中递归查找 p 和 q,返回在右子树中的结果
13        right = self.lowestCommonAncestor(root.right, p, q)
14
15        # 如果左子树和右子树都找到了 p 或 q,那么当前节点 root 就是最近公共祖先
16        # 因为 p 和 q 分别在当前节点的左右子树中
17        if left and right:
18            return root
19
20        # 如果只有左子树找到结果(right 为 None),说明 p 和 q 都在左子树中
21        # 返回左子树的结果
22        # 如果只有右子树找到结果(left 为 None),说明 p 和 q 都在右子树中
23        # 返回右子树的结果
24        return left if left else right
图论#
200. 岛屿数量#
题目描述#
给你一个由1(陆地)和0(水)组成的的二维网格,请你计算网格中岛屿的数量。
岛屿总是被水包围,并且每座岛屿只能由水平方向和/或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
示例:
输入:grid = [
  ["1","1","1","1","0"],
  ["1","1","0","1","0"],
  ["1","1","0","0","0"],
  ["0","0","0","0","0"]
]
输出:1
核心思路#
使用DFS处理岛屿数量问题时更加直观和简洁。
- 遍历网格:我们需要遍历整个网格中的每一个单元格。
- 遇到陆地时:如果遇到一个值为 ‘1’ 的单元格,表示这是一个岛屿的一部分。
- 标记岛屿:使用DFS从这个单元格开始,将所有与之相连的陆地标记为 ‘0’,以避免重复计数。
- 计数岛屿:每次启动DFS时,表示发现了一个新的岛屿,因此计数器加一。
代码#
 1class Solution:
 2    def numIslands(self, grid: List[List[str]]) -> int:
 3        # 如果网格为空,直接返回0
 4        if not grid:
 5            return 0
 6
 7        # 获取网格的行数和列数
 8        rows, cols = len(grid), len(grid[0])
 9        count = 0
10
11        def dfs(r: int, c: int):
12            """
13            使用深度优先搜索 (DFS) 标记从 (r, c) 开始的所有相连的陆地。
14            """
15            # 检查边界条件,如果超出边界或者当前单元格是水,则返回
16            if r < 0 or r >= rows or c < 0 or c >= cols or grid[r][c] == '0':
17                return
18
19            # 将当前单元格标记为已访问(即变为 '0')
20            grid[r][c] = '0'
21
22            # 递归访问上下左右四个方向
23            dfs(r + 1, c)  # 下
24            dfs(r - 1, c)  # 上
25            dfs(r, c + 1)  # 右
26            dfs(r, c - 1)  # 左
27
28        # 遍历整个网格
29        for r in range(rows):
30            for c in range(cols):
31                # 如果当前单元格是陆地('1'),则发现了一个新的岛屿
32                if grid[r][c] == '1':
33                    count += 1
34                    # 使用DFS标记整个岛屿
35                    dfs(r, c)
36
37        return count
994. 腐烂的橘子#
题目描述#
在给定的m x n网格grid中,每个单元格可以有以下三个值之一:
- 值
0代表空单元格; - 值
1代表新鲜橘子; - 值
2代表腐烂的橘子。
每分钟,腐烂的橘子周围4 个方向上相邻的新鲜橘子都会腐烂。
返回直到单元格中没有新鲜橘子为止所必须经过的最小分钟数。如果不可能,返回-1。
示例:
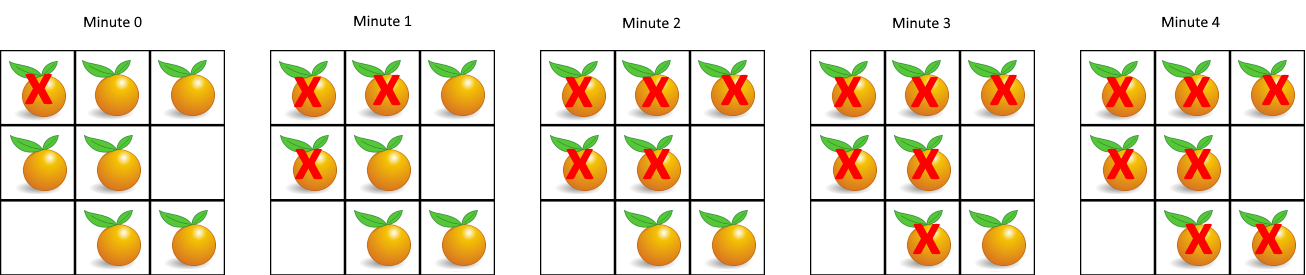
输入:grid = [[2,1,1],[1,1,0],[0,1,1]]
输出:4
核心思路#
这道题是一道经典的 “多源最短路径” 问题,可以通过广度优先搜索(BFS)来解决。
- 初始化队列:首先遍历整个网格,找到所有初始时腐烂的橘子,并将它们的位置加入到队列中。同时,统计新鲜橘子的数量。
- 广度优先搜索(BFS):使用队列进行BFS,每次处理队列中的所有腐烂橘子,将它们周围的新鲜橘子变为腐烂橘子,并将新腐烂的橘子加入队列。每处理完一轮,时间增加1分钟。
- 检查结果:当队列为空时,检查是否还有新鲜橘子。如果没有新鲜橘子,返回经过的分钟数;如果有,返回-1。
代码#
 1class Solution:
 2    def orangesRotting(self, grid: List[List[int]]) -> int:
 3        if not grid:
 4            return -1
 5
 6        rows, cols = len(grid), len(grid[0])
 7        fresh_count = 0
 8        queue = deque()
 9
10        # 初始化队列和新鲜橘子计数
11        for r in range(rows):
12            for c in range(cols):
13                if grid[r][c] == 2:
14                    queue.append((r, c))  # 将所有初始腐烂的橘子加入队列
15                elif grid[r][c] == 1:
16                    fresh_count += 1  # 统计新鲜橘子的数量
17
18        # 定义四个方向:上下左右
19        directions = [(1, 0), (-1, 0), (0, 1), (0, -1)]
20        minutes_passed = 0  # 记录时间
21
22        # 广度优先搜索
23        while queue and fresh_count > 0:
24            minutes_passed += 1  # 每处理完一轮,时间增加1分钟
25            for _ in range(len(queue)):
26                r, c = queue.popleft()  # 从队列中取出一个腐烂的橘子
27                for dr, dc in directions:
28                    nr, nc = r + dr, c + dc  # 计算相邻的单元格位置
29                    if 0 <= nr < rows and 0 <= nc < cols and grid[nr][nc] == 1:
30                        # 如果相邻单元格是新鲜橘子,将其变为腐烂橘子
31                        grid[nr][nc] = 2
32                        fresh_count -= 1  # 新鲜橘子数量减少1
33                        queue.append((nr, nc))  # 将新腐烂的橘子加入队列
34
35        # 检查是否还有新鲜橘子
36        if fresh_count == 0:
37            return minutes_passed  # 如果没有新鲜橘子,返回经过的分钟数
38        else:
39            return -1  # 如果还有新鲜橘子,返回-1
207. 课程表#
题目描述#
你这个学期必须选修numCourses门课程,记为0到numCourses - 1。
在选修某些课程之前需要一些先修课程。 先修课程按数组prerequisites给出,其中prerequisites[i] = [ai, bi],表示如果要学习课程ai则必须先学习课程bi。
- 例如,先修课程对
[0, 1]表示:想要学习课程0,你需要先完成课程1。
请你判断是否可能完成所有课程的学习?如果可以,返回true;否则,返回false。
示例:
输入:numCourses = 2, prerequisites = [[1,0]]
输出:true
解释:总共有 2 门课程。学习课程 1 之前,你需要完成课程 0 。这是可能的。
核心思路#
这个问题的核心是判断是否有依赖冲突。你可以把课程想象成一系列任务,部分任务必须先完成其他任务才能开始。如果出现循环依赖,就意味着有些任务永远无法完成(例如任务 A 依赖任务 B,B 又依赖 A),所以问题的关键就是要检查这些循环依赖是否存在。
建立依赖关系:
- 假设有很多课程,每门课可能需要先修另一门课。我们可以用一个图来表示这些课程之间的依赖关系。
- 图中的每个节点就是一门课,边则表示“先修关系”(从一门课指向另一门先修课)。
找到没有依赖的课程:
- 如果一门课不需要任何先修课(没有依赖),我们可以直接开始学这门课。
依次完成这些课程:
- 我们先学完没有依赖的课程,然后看看哪些课程现在已经可以学了(它们之前依赖的课程已经完成了)。
- 依次重复这个过程,直到所有课程都学完,或者发现有些课程永远学不了(说明有循环依赖)。
检查是否有循环依赖:
- 如果我们可以把所有课程都顺利完成,那就没有循环依赖,可以学完所有课程。
- 如果有些课程永远无法学完,那就有循环依赖,无法完成所有课程。
代码#
 1class Solution:
 2    def canFinish(self, numCourses: int, prerequisites: List[List[int]]) -> bool:
 3        # 1. 初始化邻接表和入度表
 4        # 邻接表(graph):记录每门课的后续课,即哪些课依赖于这门课
 5        # 入度表(in_degree):记录每门课有多少门前置课(依赖的课程)
 6        graph = {i: [] for i in range(numCourses)}  # 每门课的后续课程列表
 7        in_degree = {i: 0 for i in range(numCourses)}  # 每门课的前置课个数
 8
 9        # 2. 构建图结构和入度表
10        # 遍历所有的前置课程关系 [a, b],表示要先学课程 b 再学课程 a
11        for course, prereq in prerequisites:
12            graph[prereq].append(course)  # 课程 b 指向课程 a,表示 a 依赖 b
13            in_degree[course] += 1  # 课程 a 的前置课程数加 1
14
15        # 3. 找到所有没有前置课程的课程(即入度为 0 的课程)
16        queue = deque([course for course in in_degree if in_degree[course] == 0])
17
18        # 记录已经学完的课程数量
19        completed_courses = 0
20
21        # 4. 进行广度优先搜索(BFS)
22        while queue:
23            current_course = queue.popleft()  # 从队列中取出一门可以学习的课程
24            completed_courses += 1  # 这门课算作已经学完
25
26            # 对这门课的后续课程进行处理
27            for next_course in graph[current_course]:
28                in_degree[next_course] -= 1  # 该后续课的前置课程少了一门
29                if in_degree[next_course] == 0:  # 如果该课的前置课程已经全部学完
30                    queue.append(next_course)  # 将其加入队列
31
32        # 5. 判断是否所有课程都学完了
33        return completed_courses == numCourses  # 如果已学完的课程数量等于总课程数,则返回 True
208. 实现 Trie (前缀树)#
题目描述#
Trie(发音类似 “try”)或者说前缀树是一种树形数据结构,用于高效地存储和检索字符串数据集中的键。这一数据结构有相当多的应用情景,例如自动补全和拼写检查。
请你实现 Trie 类:
Trie()初始化前缀树对象。void insert(String word)向前缀树中插入字符串word。boolean search(String word)如果字符串word在前缀树中,返回true(即,在检索之前已经插入);否则,返回false。boolean startsWith(String prefix)如果之前已经插入的字符串word的前缀之一为prefix,返回true;否则,返回false。
示例:
输入:
["Trie", "insert", "search", "search", "startsWith", "insert", "search"]
[[], ["apple"], ["apple"], ["app"], ["app"], ["app"], ["app"]]
输出:
[null, null, true, false, true, null, true]

解释:
Trie trie = new Trie();
trie.insert("apple");
trie.search("apple");   // 返回 True
trie.search("app");     // 返回 False
trie.startsWith("app"); // 返回 True
trie.insert("app");
trie.search("app");     // 返回 True
核心思路#
Trie(字典树)简介:
- Trie 是一种树形结构,专门用于高效存储和查找字符串集合,常用于字典中的单词搜索。
- 每个节点代表一个字符,路径代表某个单词的前缀。
- 最常见的操作有插入一个单词、搜索某个单词是否存在、以及判断某个前缀是否存在。
init 方法:
- 初始化字典树的根节点。用一个字典(dict)来存储,根节点是空字典 {}。
insert 方法:
- 逐个字符插入到字典树中,从根节点开始。如果当前字符已经存在,则移动到下一节点;否则就创建一个新的字典节点。
- 在单词的最后一个字符插入后,添加一个特殊标记符(#),表示该节点代表一个完整单词的结束。
search 方法:
- 用于搜索某个单词是否在 Trie 中存在。
- 逐个字符从根节点开始查找,如果某个字符不在节点中,直接返回 False,表示没有这个单词。
- 如果能遍历完整个单词,并且最后一个字符的节点有结束标记符(#),说明这个单词存在。
startsWith 方法:
- 检查是否存在以某个前缀开头的单词。
- 逐个字符检查,如果当前字符在 Trie 中存在,就继续;否则返回 False,表示没有该前缀。
- 如果可以遍历完整个前缀,返回 True,表示存在这个前缀。
代码#
 1class Trie:
 2    def __init__(self):
 3        # 初始化一个空的字典树根节点,根节点本身也是一个字典
 4        self.root = {}
 5
 6    def insert(self, word: str) -> None:
 7        # 从根节点开始逐个插入字符
 8        node = self.root
 9        for char in word:
10            # 如果当前字符不在当前节点中,添加这个字符
11            if char not in node:
12                node[char] = {}
13            node = node[char]
14        # 插入完成后,在末尾标记此位置为单词结束
15        node['#'] = True  # '#' 是结束标记符,表示这个路径为一个完整单词
16
17    def search(self, word: str) -> bool:
18        # 从根节点开始搜索字符
19        node = self.root
20        for char in word:
21            # 如果字符不在节点中,则表示字典树中不存在该单词
22            if char not in node:
23                return False
24            node = node[char]
25        # 判断最后的节点是否有单词结束标记
26        return '#' in node
27
28    def startsWith(self, prefix: str) -> bool:
29        # 从根节点开始逐个字符检查前缀
30        node = self.root
31        for char in prefix:
32            # 如果前缀中的字符不在字典树中,返回 False
33            if char not in node:
34                return False
35            node = node[char]
36        # 如果可以走完前缀,说明存在该前缀
37        return True
回溯法#
46. 全排列#
题目描述#
给定一个不含重复数字的数组nums,返回其_所有可能的全排列_。你可以按任意顺序返回答案。
示例:
输入:nums = [1,2,3]
输出:[[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2],[3,2,1]]
核心思路#
回溯算法是用来解决组合、排列、子集等问题的有效方法。它通过在解的空间中一步步探索可能的解,试图找到符合要求的解集。如果发现某个路径不能达成目标,就回到上一步,尝试其他路径。
初始化:
- 首先,我们准备一个空的列表 result,用来存储所有符合条件的解,比如全排列。
- 还需要一个 path 列表,用来存储当前路径上的元素(即正在构造的一个解)。
递归函数(backtrack):
- 这是回溯算法的核心。它负责一步步地往下探索并做出选择。
- 终止条件: 当 path 的长度等于原数组的长度时(就是已经用完了所有元素),说明我们找到了一个完整的解。这时就把 path 加入 result。
- 选择与递归:
- 在每一步,我们从剩余的候选元素(比如原数组的未使用元素)中选一个,放到 path 中。
- 然后递归调用 backtrack,继续从剩下的元素中选择。
- 回溯操作:
- 当递归返回后(说明已经完成了当前路径的探索),我们要把刚才添加的元素从 path 中移除,回到上一步。这样可以进行下一次选择。
调用递归函数:
- 初始调用时,path 是空的,剩余的候选元素就是输入的数组。递归会一步步填满 path,直到找到所有可能的排列。
返回结果:
- 最后返回 result,它包含了所有符合条件的解。
代码#
【回溯解法】
 1class Solution:
 2    def permute(self, nums: List[int]) -> List[List[int]]:
 3        def backtrack(path, remaining):
 4            # 当剩余元素为空时,说明已经生成了一个完整的排列
 5            if not remaining:
 6                result.append(path[:])  # 将当前路径的副本添加到结果中(使用 path[:] 防止引用问题)
 7                return
 8            # 遍历剩余的每一个元素,尝试将其加入当前排列路径
 9            for i in range(len(remaining)):
10                # 选择:将 remaining[i] 添加到路径中
11                path.append(remaining[i])
12                # 递归:将元素 i 从剩余元素中移除,继续生成剩下的排列
13                # remaining[:i] + remaining[i+1:] 表示除了第 i 个元素的其余元素
14                backtrack(path, remaining[:i] + remaining[i+1:])
15                # 回溯:撤销选择,将刚加入的元素从路径中移除,尝试其他选择
16                path.pop()
17
18        result = []  # 存储所有生成的排列结果
19        backtrack([], nums)  # 初始时路径为空,剩余元素为 nums
20        return result  # 返回所有排列结果
【暴力递归解法】
 1class Solution:
 2    def permute(self, nums):
 3        # 如果数组为空,返回一个空列表
 4        if len(nums) == 0:
 5            return []
 6        # 如果数组只有一个元素,返回它自己
 7        if len(nums) == 1:
 8            return [nums]
 9
10        result = []
11        # 遍历数组中的每一个元素
12        for i in range(len(nums)):
13            # 当前选择的元素
14            current = nums[i]
15            # 剩余的元素(除了当前元素之外的部分)
16            remaining = nums[:i] + nums[i+1:]
17
18            # 对剩余元素递归生成所有排列
19            for p in self.permute(remaining):
20                # 将当前元素加入到递归生成的排列前面
21                result.append([current] + p)
22
23        return result
78. 子集#
题目描述#
给你一个整数数组nums,数组中的元素互不相同。返回该数组所有可能的子集(幂集)。
解集不能包含重复的子集。你可以按任意顺序返回解集。
示例:
输入:nums = [1,2,3]
输出:[[],[1],[2],[1,2],[3],[1,3],[2,3],[1,2,3]]
核心思路#
使用了迭代的方法来生成一个数组的所有子集。具体来说,通过逐步扩展当前已有的子集来生成新的子集。
初始化结果列表:
- 初始化结果列表result,其中包含一个空子集。这是因为在任何数组的子集中,空集总是存在的。
遍历每个元素:
- 遍历输入数组nums中的每个元素num。对于每个元素,我们都会生成新的子集并将其添加到结果列表中。
生成新的子集:
- 对于当前结果列表result中的每个子集subset,生成一个新的子集,该子集是在原子集的基础上加上当前元素num。
- 将新生成的子集直接添加到结果列表result中。extend方法会将可迭代对象中的所有元素添加到列表的末尾。
返回结果:
- 返回包含所有子集的结果列表result。
代码#
 1class Solution:
 2    def subsets(self, nums: List[int]) -> List[List[int]]:
 3        result = [[]]
 4
 5        # 遍历 nums 数组中的每个元素
 6        for num in nums:
 7            # 使用列表推导式生成新的子集并直接添加到结果集中
 8            result.extend(subset + [num] for subset in result)
 9
10        return result
17. 电话号码的字母组合#
题目描述#
给定一个仅包含数字2-9的字符串,返回所有它能表示的字母组合。答案可以按任意顺序返回。
给出数字到字母的映射如下(与电话按键相同)。注意 1 不对应任何字母。
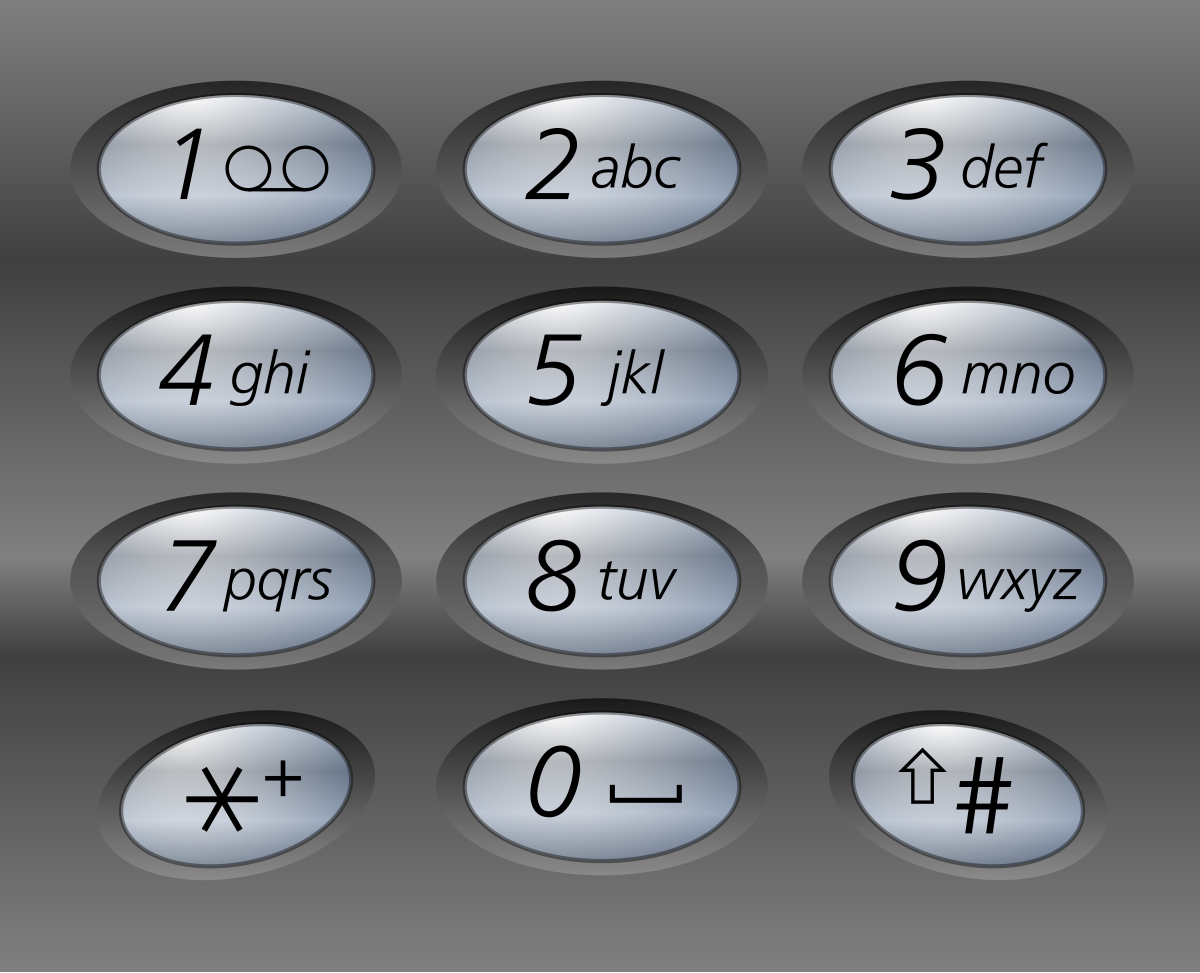 示例:
输入:digits = "23"
输出:["ad","ae","af","bd","be","bf","cd","ce","cf"]
核心思路#
这个问题的核心是将数字和字母映射,根据给定的数字字符串生成所有可能的字母组合。
映射关系:首先,将每个数字映射到对应的字母,类似于手机键盘上的按键。
组合构建:从给定的数字字符串中的每个数字开始,逐步构建字母组合。每次处理一个数字时,将这个数字对应的所有字母依次加到已经生成的所有组合的末尾。
迭代更新:初始时,组合是空的 [’’],然后遍历每个数字,逐步构建新的组合,直到所有数字都被处理完。每处理一个数字,结果集就会扩展,加入所有可能的新组合。
最终结果:当所有数字都处理完后,生成的列表就是所有可能的字母组合。
代码#
 1class Solution:
 2    def letterCombinations(self, digits: str) -> List[str]:
 3        if not digits:
 4            return []
 5
 6        digit_to_letters = {
 7            '2': 'abc', '3': 'def', '4': 'ghi', '5': 'jkl',
 8            '6': 'mno', '7': 'pqrs', '8': 'tuv', '9': 'wxyz'
 9        }
10
11        result = ['']
12
13        for digit in digits:
14            # 重新构建结果列表,每个结果加上当前数字对应的字母
15            new_result = []
16            for letter in digit_to_letters[digit]:
17                for combination in result:
18                    new_result.append(combination + letter)
19            result = new_result
20
21        return result
39. 组合总和#
题目描述#
给你一个无重复元素的整数数组candidates和一个目标整数target,找出candidates中可以使数字和为目标数target的 所有不同组合,并以列表形式返回。你可以按任意顺序返回这些组合。
candidates中的同一个数字可以无限制重复被选取。如果至少一个数字的被选数量不同,则两种组合是不同的。
对于给定的输入,保证和为target的不同组合数少于150个。
示例:
输入:candidates = [2,3,6,7], target = 7
输出:[[2,2,3],[7]]
解释:
2 和 3 可以形成一组候选,2 + 2 + 3 = 7 。注意 2 可以使用多次。
7 也是一个候选, 7 = 7 。
仅有这两种组合。
核心思路#
通过递归不断尝试所有可能的组合,最终找到那些和等于目标数的组合。
递归探索:从数组 candidates 中选择一个元素开始尝试,不断向当前组合中添加元素,直到总和等于目标数 target。如果总和超过目标数,就回退(回溯)。
剪枝优化:为了避免重复计算,每次递归时,我们只考虑当前元素及其之后的元素(避免重复组合)。
重复选择元素:因为题目允许一个数字可以被无限制重复使用,因此递归时可以再次选择当前元素。
代码#
 1class Solution:
 2    def combinationSum(self, candidates, target):
 3        result = []
 4
 5        # 回溯函数,参数分别是当前组合路径、当前的总和、候选元素的起始索引
 6        def backtrack(remaining, path, start):
 7            # 如果剩余的数为 0,说明找到了一组合法的组合,加入结果集
 8            if remaining == 0:
 9                result.append(path[:])
10                return
11            # 如果剩余数小于 0,说明当前组合不合法,直接返回
12            if remaining < 0:
13                return
14
15            # 从当前元素开始,尝试每个候选元素
16            for i in range(start, len(candidates)):
17                # 选择当前元素,递归搜索
18                path.append(candidates[i])
19                # 递归调用,remaining 减去当前元素,start 保持不变以允许重复选择同一元素
20                backtrack(remaining - candidates[i], path, i)
21                # 回溯:撤销当前选择
22                path.pop()
23
24        # 调用回溯函数,初始路径为空,目标是 target,从第 0 个元素开始
25        backtrack(target, [], 0)
26
27        return result
22. 括号生成#
题目描述#
数字n代表生成括号的对数,请你设计一个函数,用于能够生成所有可能的并且有效的括号组合。
示例:
输入:n = 3
输出:["((()))","(()())","(())()","()(())","()()()"]
核心思路#
条件判断:
- 有效的括号 有两个关键条件:
- 左括号的数量不能超过 n,即在递归过程中,我们不能放置超过 n 个左括号。
- 右括号的数量不能超过已经放置的左括号数量,保证当前组合是有效的。
- 有效的括号 有两个关键条件:
递归终止条件:
- 当生成的字符串的长度等于 2 * n,说明所有括号对都放置完毕,我们将当前生成的字符串加入结果列表中。
回溯过程:
- 每次递归时,我们有两个选择:
- 如果左括号还没放满(left < n),我们可以放一个左括号 ‘(’。
- 如果右括号数量小于左括号(right < left),可以放一个右括号 ‘)’。
- 放置一个括号后,继续递归构建剩下的组合;一旦递归完成后,回溯到之前的状态,尝试其他可能。
- 每次递归时,我们有两个选择:
代码#
 1class Solution:
 2    def generateParenthesis(self, n: int) -> List[str]:
 3        def backtrack(path, left, right):
 4            # 如果生成的括号长度达到了 2 * n,说明所有括号对已经放置完毕
 5            if len(path) == 2 * n:
 6                result.append("".join(path))  # 将生成的括号组合加入结果列表
 7                return
 8
 9            # 如果左括号数量还没有达到 n,继续放置左括号
10            if left < n:
11                path.append('(')  # 放置左括号
12                backtrack(path, left + 1, right)  # 递归
13                path.pop()  # 回溯,撤销放置的左括号
14
15            # 如果右括号数量小于左括号数量,继续放置右括号
16            if right < left:
17                path.append(')')  # 放置右括号
18                backtrack(path, left, right + 1)  # 递归
19                path.pop()  # 回溯,撤销放置的右括号
20
21        result = []
22        backtrack([], 0, 0)  # 初始状态:空路径,0 左括号,0 右括号
23        return result
79. 单词搜索#
题目描述#
给定一个m x n二维字符网格board和一个字符串单词word。如果word存在于网格中,返回true;否则,返回false。
单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中“相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母不允许被重复使用。
示例:
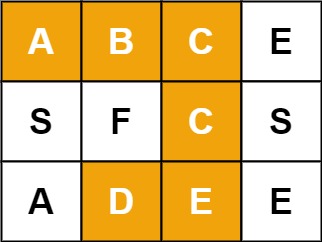
输入:board = [["A","B","C","E"],["S","F","C","S"],["A","D","E","E"]], word = "ABCCED"
输出:true
核心思路#
- 搜索起点:
- 从网格中的每个位置作为起点,尝试查找单词的第一个字母。
- 递归查找:
- 从匹配到的第一个字母开始,递归地查找下一个字母。
- 每个递归步骤中,我们会尝试向四个方向(上下左右)移动,寻找下一个字母。
- 回溯:
- 如果找到匹配的单词,返回 true。
- 如果当前路径无法匹配到单词,回溯并尝试其他可能的路径。
- 终止条件:
- 如果匹配到了单词的所有字母,返回 true。
- 如果当前字符不匹配或越界,则停止当前路径的搜索。
代码#
 1class Solution:
 2    def exist(self, board: List[List[str]], word: str) -> bool:
 3        rows, cols = len(board), len(board[0])
 4
 5        # 定义回溯函数,参数为当前搜索的行、列以及当前匹配到的字符索引
 6        def backtrack(r, c, index):
 7            if index == len(word):
 8                return True
 9
10            # 如果越界,或者当前单元格的字符不匹配,返回 False
11            if r < 0 or r >= rows or c < 0 or c >= cols or board[r][c] != word[index]:
12                return False
13
14            # 暂时标记这个单元格为已访问,避免重复使用
15            temp, board[r][c] = board[r][c], '#'
16
17            # 四个方向进行探索:上、下、左、右
18            found = (
19                backtrack(r + 1, c, index + 1) or  # 向下
20                backtrack(r - 1, c, index + 1) or  # 向上
21                backtrack(r, c + 1, index + 1) or  # 向右
22                backtrack(r, c - 1, index + 1)     # 向左
23            )
24
25            # 回溯:恢复当前单元格的值
26            board[r][c] = temp
27
28            return found
29
30        # 遍历每一个网格中的位置,尝试寻找单词的第一个字母
31        for i in range(rows):
32            for j in range(cols):
33                # 如果从某个位置找到了单词,直接返回 True
34                if backtrack(i, j, 0):
35                    return True
36
37        # 如果遍历完所有的起点都没有找到,返回 False
38        return False
131. 分割回文串#
题目描述#
给你一个字符串s,请你将s分割成一些子串,使每个子串都是回文串。返回s所有可能的分割方案。
示例:
输入:s = "aab"
输出:[["a","a","b"],["aa","b"]]
核心思路#
选择分割点:
- 从字符串的起始位置开始,每次选择一个分割点,将字符串分割成一个前缀(子串)和剩余的部分。
- 检查前缀是否是回文串,如果是,则递归处理剩余的部分。
递归和回溯:
- 对于每个分割点,如果当前子串是回文串,则递归地处理剩余部分。
- 一旦递归到字符串的末尾,说明已经完成了一次有效的分割,将结果加入最终解集中。
- 回溯时,撤销上一步的选择,继续尝试新的分割方案。
回文检查:
- 使用一个辅助函数来判断一个字符串是否是回文。
代码#
 1class Solution:
 2    def partition(self, s: str) -> List[List[str]]:
 3        def is_palindrome(sub: str) -> bool:
 4            # 判断子串是否是回文
 5            return sub == sub[::-1]
 6
 7        def backtrack(start: int, path: List[str]):
 8            # 递归终止条件:如果已经到达字符串末尾,表示完成了一次有效分割
 9            if start == len(s):
10                result.append(path[:])
11                return
12
13            # 尝试从 start 开始的每一个位置分割字符串
14            for end in range(start + 1, len(s) + 1):
15                # 获取当前子串 s[start:end]
16                substring = s[start:end]
17
18                # 如果当前子串是回文,继续递归处理剩余部分
19                if is_palindrome(substring):
20                    path.append(substring)  # 选择当前子串
21                    backtrack(end, path)    # 递归处理剩余部分
22                    path.pop()              # 回溯,撤销选择
23
24        result = []
25        backtrack(0, [])
26        return result
二分查找#
35. 搜索插入位置#
题目描述#
给定一个排序数组和一个目标值,在数组中找到目标值,并返回其索引。如果目标值不存在于数组中,返回它将会被按顺序插入的位置。
请必须使用时间复杂度为O(log n)的算法。
示例:
输入:nums = [1,3,5,6], target = 5
输出:2

输入:nums = [1,3,5,6], target = 7
输出:4
核心思路#
- 初始化:设置两个指针left和right分别指向数组的起始和结束位置。
- 二分查找:
- 计算中间索引mid = left + (right - left) // 2。
- 如果nums[mid]等于目标值target,返回mid。
- 如果nums[mid]大于目标值,更新right为mid - 1。
- 如果nums[mid]小于目标值,更新left为mid + 1。
- 返回插入位置:如果没有找到目标值,循环结束后left即为目标值将要被插入的位置。
代码#
 1class Solution:
 2    def searchInsert(self, nums: List[int], target: int) -> int:
 3        left, right = 0, len(nums) - 1
 4        while left <= right:
 5            mid = left + (right - left) // 2
 6            if nums[mid] == target:
 7                return mid
 8            elif nums[mid] > target:
 9                right = mid - 1
10            else:
11                left = mid + 1
12        return left
74. 搜索二维矩阵#
题目描述#
给你一个满足下述两条属性的m x n整数矩阵:
- 每行中的整数从左到右按非严格递增顺序排列。
- 每行的第一个整数大于前一行的最后一个整数。
给你一个整数target,如果target在矩阵中,返回true;否则,返回false。
示例:

输入:matrix = [[1,3,5,7],[10,11,16,20],[23,30,34,60]], target = 3
输出:true
核心思路#
从矩阵的右上角开始搜索,这样每一步都可以通过比较大小来确定下一步的方向。详细步骤如下:
从右上角开始:我们选择从矩阵的右上角(即第一行的最后一个元素)开始。这个位置有一个特殊的性质:
- 如果当前元素比目标值 target 大,我们可以往左移动,因为同一行左边的元素更小。
- 如果当前元素比目标值 target 小,我们可以向下移动,因为同一列下面的元素更大。
不断缩小搜索空间:根据上面的逻辑,我们每次都可以抛弃一整行或一整列,因此每次比较都有效地缩小了搜索范围。
终止条件:如果找到了目标值,返回 True。如果搜索越界(即行列索引超出矩阵范围),则返回 False,表示未找到目标值。
代码#
 1class Solution:
 2    def searchMatrix(self, matrix: List[List[int]], target: int) -> bool:
 3        # 获取矩阵的行数和列数
 4        if not matrix or not matrix[0]:
 5            return False
 6        rows, cols = len(matrix), len(matrix[0])
 7
 8        # 从右上角开始,rows行数,cols列数
 9        row, col = 0, cols - 1
10
11        while row < rows and col >= 0:
12            if matrix[row][col] == target:
13                return True
14            elif matrix[row][col] > target:
15                # 如果当前元素比目标大,向左移动
16                col -= 1
17            else:
18                # 如果当前元素比目标小,向下移动
19                row += 1
20
21        return False
34. 在排序数组中查找元素的第一个和最后一个位置#
题目描述#
给你一个按照非递减顺序排列的整数数组nums,和一个目标值target。请你找出给定目标值在数组中的开始位置和结束位置。
如果数组中不存在目标值target,返回[-1, -1]。
你必须设计并实现时间复杂度为O(log n)的算法解决此问题。
示例:
输入:nums = [5,7,7,8,8,10], target = 8
输出:[3,4]
核心思路#
要实现时间复杂度为 O(log n) 的算法解决这个问题,可以使用二分查找。 具体来说,我们需要两次二分查找:一次找到目标值的开始位置,另一次找到目标值的结束位置。
找到目标值的开始位置:
- 使用二分查找,但当找到目标值时,不立即返回,而是继续向左查找,直到找到最左边的目标值。
找到目标值的结束位置:
- 使用二分查找,但当找到目标值时,不立即返回,而是继续向右查找,直到找到最右边的目标值。
处理不存在目标值的情况:
- 如果在第一次查找中没有找到目标值,直接返回 [-1, -1]。
代码#
 1class Solution:
 2    def searchRange(nums, target):
 3        def binary_search(nums, target, find_first):
 4            left, right = 0, len(nums) - 1
 5            result = -1
 6            while left <= right:
 7                mid = (left + right) // 2
 8                if nums[mid] == target:
 9                    result = mid
10                    if find_first:
11                        right = mid - 1  # 寻找左边界
12                    else:
13                        left = mid + 1   # 寻找右边界
14                elif nums[mid] < target:
15                    left = mid + 1
16                else:
17                    right = mid - 1
18            return result
19
20        start = binary_search(nums, target, True)
21        end = binary_search(nums, target, False)
22
23        return [start, end] if start != -1 else [-1, -1]
33. 搜索旋转排序数组#
题目描述#
整数数组nums按升序排列,数组中的值互不相同。
在传递给函数之前,nums在预先未知的某个下标k(0 <= k < nums.length)上进行了旋转,使数组变为[nums[k], nums[k+1], ..., nums[n-1], nums[0], nums[1], ..., nums[k-1]](下标从 0 开始计数)。例如,[0,1,2,4,5,6,7]在下标3处经旋转后可能变为[4,5,6,7,0,1,2]。
给你旋转后的数组nums和一个整数target,如果nums中存在这个目标值target,则返回它的下标,否则返回-1。
你必须设计一个时间复杂度为O(log n)的算法解决此问题。
示例:
输入:nums = [4,5,6,7,0,1,2], target = 0
输出:4
核心思路#
- 初始化:定义两个指针left和right分别指向数组的起始和结束位置。
- 中间值:计算中间位置mid。
- 比较:
- 如果nums[mid]等于target,返回mid。
- 如果nums[left]到nums[mid]是有序的:
- 检查target是否在这个有序区间内。
- 如果在,调整right指针;否则,调整left指针。
- 如果nums[mid]到nums[right]是有序的:
- 检查target是否在这个有序区间内。
- 如果在,调整left指针;否则,调整right指针。
- 循环:重复上述步骤,直到left超过right。
- 返回结果:如果循环结束仍未找到target,返回 -1。
代码#
 1class Solution:
 2    def search(self, nums: List[int], target: int) -> int:
 3        left, right = 0, len(nums) - 1
 4
 5        while left <= right:
 6            mid = (left + right) // 2
 7
 8            # 如果找到目标值,直接返回
 9            if nums[mid] == target:
10                return mid
11
12            # 判断左半部分是否有序
13            if nums[left] <= nums[mid]:
14                # 如果目标值在左半部分的有序区间中
15                if nums[left] <= target < nums[mid]:
16                    right = mid - 1  # 缩小右边界,继续在左半部分查找
17                else:
18                    left = mid + 1   # 否则,目标值可能在右半部分
19            # 否则右半部分有序
20            else:
21                # 如果目标值在右半部分的有序区间中
22                if nums[mid] < target <= nums[right]:
23                    left = mid + 1   # 缩小左边界,继续在右半部分查找
24                else:
25                    right = mid - 1  # 否则,目标值可能在左半部分
26
27        return -1
153. 寻找旋转排序数组中的最小值#
题目描述#
已知一个长度为n的数组,预先按照升序排列,经由1到n次旋转后,得到输入数组。例如,原数组nums = [0,1,2,4,5,6,7]在变化后可能得到:
- 若旋转
4次,则可以得到[4,5,6,7,0,1,2] - 若旋转
7次,则可以得到[0,1,2,4,5,6,7]
注意,数组[a[0], a[1], a[2], ..., a[n-1]]旋转一次的结果为数组[a[n-1], a[0], a[1], a[2], ..., a[n-2]]。
给你一个元素值互不相同的数组nums,它原来是一个升序排列的数组,并按上述情形进行了多次旋转。请你找出并返回数组中的最小元素。
你必须设计一个时间复杂度为O(log n)的算法解决此问题。
示例:
输入:nums = [3,4,5,1,2]
输出:1
解释:原数组为 [1,2,3,4,5] ,旋转 3 次得到输入数组。
核心思路#
首先,假设原数组是严格递增的,并且经过了旋转,导致一部分数组无序。为了理解,我们需要明确 有序部分和 无序部分 的定义: - 有序部分:在旋转后,仍然保持元素从小到大排列的区间。 - 无序部分:由于旋转导致其中部分元素的顺序被打乱的区间(即最小值所在的区间)。
在旋转后的数组中,如果整个数组仍然是有序的(没有旋转或者旋转了完整长度),那么最小值就是数组的第一个元素。如果数组被旋转了,则会出现 无序部分,最小值一定出现在这个无序部分中。
通过 中间元素 nums[mid] 和数组最右端元素 nums[right] 来判断: 1. nums[mid] > nums[right]: - 如果 mid 元素大于 right 元素,说明 mid 元素所在的区域是无序的。因为 nums[mid] 本应该小于 nums[right],但由于旋转,顺序被破坏了。 - 在这种情况下,最小元素一定在 mid 右边。这是因为 nums[mid] > nums[right],所以在右边部分才有可能找到比 nums[right] 更小的元素。 2. nums[mid] < nums[right]: - 如果 mid 元素小于 right 元素,说明 mid 到 right 的这部分是有序的,也就是说,nums[mid] 是这一段中的最小值。 - 在这种情况下,最小值可能在 mid 左边(包括 mid 本身)。因为右边已经有序,最小值不会在右边,而可能在左边。
代码#
 1class Solution:
 2    def findMin(self, nums: List[int]) -> int:
 3        left, right = 0, len(nums) - 1
 4
 5        while left < right:
 6            mid = (left + right) // 2
 7
 8            # 如果中间值大于最右边的值,说明最小值在右半部分
 9            if nums[mid] > nums[right]:
10                left = mid + 1
11            # 否则,最小值在左半部分(包括 mid 自己)
12            else:
13                right = mid
14
15        # 当 left == right 时,找到了最小值
16        return nums[left]
栈#
20. 有效的括号#
题目描述#
给定一个只包括'(',')','{','}','[',']'的字符串s,判断字符串是否有效。
有效字符串需满足:
- 左括号必须用相同类型的右括号闭合。
- 左括号必须以正确的顺序闭合。
- 每个右括号都有一个对应的相同类型的左括号。
示例:
输入:s = "()"

输出:true

输入:s = "()[]{}"

输出:true
核心思路#
遍历s字符串:
当s[i]为左括号时,将s[i]压栈
当s[i]为右括号时,分为两种情况:
- 若栈为空,则栈顶元素无法弹出与s[i]匹配,返回False;
- 若栈不为空,则弹出栈顶元素与s[i]匹配。
- 当栈顶元素与s[i]匹配时,则继续遍历字符串中下一个元素;
- 当栈顶元素和s[i]不匹配时,则返回False
时间复杂度:由于压栈和弹栈操作的时间复杂度均为O(1),因此本题的时间复杂度取决于对字符串的遍历,所以为O(n)
代码#
 1class Solution:
 2    def isValid(self, s: str) -> bool:
 3        stack=[]
 4        bracketsMatch={"(":1,"[":2,"{":3,"}":4,"]":5,")":6}
 5        for i in range(len(s)):
 6            #若为左括号,则入栈
 7            if bracketsMatch[s[i]]<=3:
 8                stack.append(s[i])
 9            else:#若为右括号
10                #首先,若栈此时为空,则return false
11                if len(stack)==0:
12                    return False
13                else:
14                    if bracketsMatch[s[i]]+bracketsMatch[stack.pop()]!=7:
15                        return False
16        return True if len(stack)==0 else False
155. 最小栈#
题目描述#
设计一个支持push,pop,top操作,并能在常数时间内检索到最小元素的栈。
实现MinStack类:
MinStack()初始化堆栈对象。void push(int val)将元素val推入堆栈。void pop()删除堆栈顶部的元素。int top()获取堆栈顶部的元素。int getMin()获取堆栈中的最小元素。
示例:
输入:
["MinStack","push","push","push","getMin","pop","top","getMin"]
[[],[-2],[0],[-3],[],[],[],[]]

*输出:
[null,null,null,null,-3,null,0,-2]

解释:
MinStack minStack = new MinStack();
minStack.push(-2);
minStack.push(0);
minStack.push(-3);
minStack.getMin();   --> 返回 -3.
minStack.pop();
minStack.top();      --> 返回 0.
minStack.getMin();   --> 返回 -2.
核心思路#
代码#
 1class MinStack:
 2
 3    def __init__(self):
 4        self.stack = []
 5        self.min_stack = []
 6
 7    def push(self, val: int) -> None:
 8        self.stack.append(val)
 9        if not self.min_stack or val <= self.min_stack[-1]:
10            self.min_stack.append(val)
11
12    def pop(self) -> None:
13        val = self.stack.pop()
14        if val == self.min_stack[-1]:
15            self.min_stack.pop()
16
17    def top(self) -> int:
18        return self.stack[-1]
19
20    def getMin(self) -> int:
21        return self.min_stack[-1]
394. 字符串解码#
题目描述#
给定一个经过编码的字符串,返回它解码后的字符串。
编码规则为:k[encoded_string],表示其中方括号内部的encoded_string正好重复k次。注意k保证为正整数。
你可以认为输入字符串总是有效的;输入字符串中没有额外的空格,且输入的方括号总是符合格式要求的。
此外,你可以认为原始数据不包含数字,所有的数字只表示重复的次数k,例如不会出现像3a或2[4]的输入。
示例:
输入:s = "3[a]2[bc]"
输出:"aaabcbc"
核心思路#
栈的数据结构非常适合处理嵌套的情况。
初始化栈:创建一个空栈,用于存储数字(重复次数)和字符串。
遍历字符串:
- 如果当前字符是数字,则计算该数字(可能有多位)。
- 如果当前字符是[,将之前计算的数字压入栈中,并重置数字。
- 如果当前字符是字母,则将其添加到当前正在构建的字符串中。
- 如果当前字符是],则从栈中弹出最近的数字和字符串,并将当前构建的字符串重复该数字次,然后将结果添加到前一个部分的字符串中。
返回结果:遍历结束后,最终构建的字符串即为解码后的字符串。
代码#
 1class Solution:
 2    def decodeString(self, s: str) -> str:
 3        # 初始化栈、当前数字和当前字符串
 4        stack = []            # 用于存储之前的字符串和重复次数
 5        current_num = 0        # 当前数字,用于表示字符串重复的次数
 6        current_string = ""    # 当前构建的字符串
 7
 8        # 遍历给定的字符串 s 中的每个字符
 9        for char in s:
10            if char.isdigit():
11                # 如果遇到数字字符,则更新当前数字
12                # 处理连续的数字字符,将它们组合成一个完整的数字
13                current_num = current_num * 10 + int(char)
14            elif char == '[':
15                # 如果遇到开括号 '[',将当前字符串和当前数字保存到栈中
16                # 并重置 current_string 和 current_num,准备处理括号内部的子字符串
17                stack.append((current_string, current_num))
18                current_string, current_num = "", 0  # 重置当前字符串和数字
19            elif char == ']':
20                # 如果遇到闭括号 ']',从栈中弹出之前的字符串和数字
21                # 生成重复的字符串,将其与之前的字符串连接起来
22                prev_string, num = stack.pop()  # 弹出上一个字符串和对应的重复次数
23                current_string = prev_string + num * current_string  # 重复当前字符串并与之前的字符串拼接
24            else:
25                # 如果是普通的字母字符,则将其追加到当前字符串中
26                current_string += char
27
28        # 返回最终构建的解码字符串
29        return current_string
题目描述#
给定一个整数数组temperatures,表示每天的温度,返回一个数组answer,其中answer[i]是指对于第i天,下一个更高温度出现在几天后。如果气温在这之后都不会升高,请在该位置用0来代替。
示例:
输入:temperatures = [73,74,75,71,69,72,76,73]
输出:[1,1,4,2,1,1,0,0]
核心思路#
通过单调栈(Monotonic Stack)来高效解决。具体来说,我们可以利用一个栈来存储温度的索引,这样可以方便地计算天数差。
初始化:
- 创建一个结果数组answer,长度与temperatures相同,初始值为0。
- 创建一个空的栈stack,用于存储温度的索引。
遍历温度数组:
- 对于每个温度temperatures[i]:
- 如果栈不为空且当前温度temperatures[i]大于栈顶索引对应的温度temperatures[stack[-1]],则:
- 弹出栈顶索引index。
- 计算天数差i - index,并将结果存入answer[index]。
- 将当前索引i压入栈。
- 如果栈不为空且当前温度temperatures[i]大于栈顶索引对应的温度temperatures[stack[-1]],则:
- 对于每个温度temperatures[i]:
返回结果:
- 遍历完成后,栈中剩余的索引对应的结果已经默认为0,表示之后没有更高的温度。
代码#
 1class Solution:
 2    def dailyTemperatures(self, temperatures: List[int]) -> List[int]:
 3        n = len(temperatures)  # 获取温度列表的长度
 4        answer = [0] * n  # 初始化答案列表,初始值为 0,表示没有比当前温度高的日子
 5        stack = []  # 栈,用来存储尚未找到更高温度的索引
 6
 7        for i in range(n):
 8            # 使用 while 循环检查栈顶元素对应的温度是否小于当前温度
 9            # 如果是,则说明当前温度高于栈顶对应的温度,我们可以计算等待的天数
10            while stack and temperatures[i] > temperatures[stack[-1]]:
11                index = stack.pop()  # 栈顶的温度索引
12                answer[index] = i - index  # 计算等待的天数,并将其存入答案列表
13
14            # 将当前温度的索引压入栈中,以便后续处理
15            stack.append(i)
16
17        return answer
堆#
215. 数组中的第K个最大元素#
题目描述#
给定整数数组nums和整数k,请返回数组中第k个最大的元素。
请注意,你需要找的是数组排序后的第k个最大的元素,而不是第k个不同的元素。
你必须设计并实现时间复杂度为O(n)的算法解决此问题。
示例:
输入:[3,2,1,5,6,4], k = 2
输出:5
核心思路#
维护大小为 k 的最小堆:
- 在遍历数组 nums 时,我们使用一个堆,且堆的大小始终保持为 k。这是关键点:堆的大小总是 k。
- 堆的特点是堆顶元素是堆中最小的元素。因此,堆中的元素始终是当前遍历过的元素中最大的 k 个元素,而堆顶元素将是这些元素中最小的,也就是整个数组中第 k 大的元素。
堆操作的流程:
- 每次遇到一个新的元素 num 时,我们将它加入到最小堆中。
- 然后检查堆的大小,如果堆的大小超过 k,我们会移除堆顶元素。因为堆顶是最小的元素,这样做的目的是确保堆中只保留最大的 k 个元素。
最终的结果:
- 当遍历完所有元素后,最小堆中包含的是数组 nums 中最大的 k 个元素,而堆顶的最小元素正好是这 k 个元素中最小的一个,也就是整个数组中的第 k 大元素。
- 时间复杂度:对于每个元素插入堆的时间复杂度是 O(logk),我们有 n 个元素,因此总体的时间复杂度为 O(nlogk)。
- 空间复杂度:堆的大小始终为 k,因此空间复杂度为 O(k)。
代码#
【最小堆】
 1class Solution:
 2    def findKthLargest(self, nums: list[int], k: int) -> int:
 3        # 使用大小为 k 的最小堆
 4        min_heap = []
 5
 6        for num in nums:
 7            heapq.heappush(min_heap, num)
 8            # 如果堆的大小超过 k,弹出堆顶最小值
 9            if len(min_heap) > k:
10                heapq.heappop(min_heap)
11
12        # 堆顶即为第 k 大的元素
13        return min_heap[0]
【快速选择】
 1class Solution:
 2    def findKthLargest(self, nums: List[int], k: int) -> int:
 3        def quick_select(nums, k):
 4            """
 5            Quickselect 函数:通过递归在数组中找到第 k 大的元素。
 6            通过选择一个 pivot(枢轴),将数组分成两部分:
 7              - `larger`: 所有大于 pivot 的元素
 8              - `smaller`: 所有小于 pivot 的元素
 9            然后根据 k 判断在哪部分递归继续查找。
10            """
11            # 随机选择一个 pivot 来避免最坏情况
12            pivot = random.choice(nums)
13
14            # 分成三部分:比 pivot 大的、比 pivot 小的和等于 pivot 的
15            larger = [num for num in nums if num > pivot]
16            smaller = [num for num in nums if num < pivot]
17
18            # k <= len(larger) 意味着我们正在寻找的第 k 大元素在 larger 部分中。
19            if k <= len(larger):
20                return quick_select(larger, k)
21
22            # 如果 k 大于 len(larger) + len(equal),我们需要在 smaller 部分中递归查找
23            # 由于我们已经排除了 larger 和 equal 部分的元素
24            # 因此是在剩下的 smaller 部分寻找第 k - (len(larger) + len(equal)) 大的元素。
25            if k > len(nums) - len(smaller):
26                return quick_select(smaller, k - (len(nums) - len(smaller)))
27
28            # 否则,pivot 就是第 k 大的元素
29            return pivot
30
31        return quick_select(nums, k)
347. 前 K 个高频元素#
题目描述#
给你一个整数数组nums和一个整数k,请你返回其中出现频率前k高的元素。你可以按任意顺序返回答案。
示例:
输入:nums = [1,1,1,2,2,3], k = 2
输出:[1,2]
核心思路#
使用哈希表计数:我们可以遍历数组,记录每个数字出现的次数,使用哈希表(字典)来存储每个数字的频率。
获取前 k 个高频元素:我们可以通过一些方式从频率中找到前 k 个出现频率最高的元素。最直接的方式是使用堆或直接排序。
代码#
【Counter + 最小堆】时间复杂度:O(n log k)
 1class Solution:
 2    def topKFrequent(self, nums: list[int], k: int) -> list[int]:
 3        # 1. 使用 Counter 统计每个数字的出现频率
 4        count = Counter(nums)
 5
 6        # 2. 构建一个最小堆,大小为 k
 7        # heapq 可以维护一个最小堆,堆中存储的是 (频率, 数字)
 8        min_heap = []
 9
10        for num, freq in count.items():
11            # 将当前元素及其频率加入堆中
12            heapq.heappush(min_heap, (freq, num))
13            # 如果堆的大小超过 k,移除频率最低的元素
14            if len(min_heap) > k:
15                heapq.heappop(min_heap)
16
17        # 3. 从最小堆中提取出频率最高的 k 个元素(此时堆中正好有 k 个元素)
18        return [num for freq, num in min_heap]
【Counter + 排序】时间复杂度:O(n log n)
 1class Solution:
 2    def topKFrequent(self, nums: list[int], k: int) -> list[int]:
 3        # 1. 使用 Counter 统计每个数字的出现频率
 4        count = Counter(nums)
 5
 6        # 2. 使用 most_common 方法找到频率最高的 k 个元素
 7        # most_common(k) 返回频率最高的前 k 个元素
 8        result = []
 9        for num, freq in count.most_common(k):
10            result.append(num)
11
12        return result
贪心算法#
121. 买卖股票的最佳时机#
题目描述#
给定一个数组prices,它的第i个元素prices[i]表示一支给定股票第i天的价格。
你只能选择某一天买入这只股票,并选择在未来的某一个不同的日子卖出该股票。设计一个算法来计算你所能获取的最大利润。
返回你可以从这笔交易中获取的最大利润。如果你不能获取任何利润,返回0。
示例:
输入:[7,1,5,3,6,4]
输出:5
解释:在第 2 天(股票价格 = 1)的时候买入,在第 5 天(股票价格 = 6)的时候卖出,最大利润 = 6-1 = 5 。
     注意利润不能是 7-1 = 6, 因为卖出价格需要大于买入价格;同时,你不能在买入前卖出股票。
核心思路#
【贪心算法】
- 保持最低价格:记录到目前为止的最低股价 min_price。
- 计算最大利润:
- 对于每一天的股价,计算如果在这一天卖出股票的利润,即 prices[i] - min_price。
- 不断更新最大利润 max_profit。
总结:通过维护一个最低买入价和当前最大利润,每天更新这两个数值来计算最大可能利润。
代码#
 1class Solution(object):
 2    def maxProfit(self, prices):
 3        if len(prices) == 1:
 4            return 0
 5        min_price = prices[0]
 6        max_profit = 0
 7        for i in range(1, len(prices)):
 8            min_price = min(min_price, prices[i])
 9            max_profit = max(max_profit, prices[i] - min_price)
10
11        return max_profit
55. 跳跃游戏#
题目描述#
给你一个非负整数数组nums,你最初位于数组的第一个下标。数组中的每个元素代表你在该位置可以跳跃的最大长度。
判断你是否能够到达最后一个下标,如果可以,返回true;否则,返回false。
示例:
输入:nums = [2,3,1,1,4]
输出:true
解释:可以先跳 1 步,从下标 0 到达下标 1, 然后再从下标 1 跳 3 步到达最后一个下标。
核心思路#
贪心策略:每次在当前位置,计算从该位置能够到达的最远位置,并更新一个变量 max_reachable 来记录能够到达的最远下标。
遍历数组:从第一个下标开始遍历数组:
- 如果当前下标i超过了max_reachable,这意味着无法从之前的任何位置跳到当前位置,因此直接返回False。
- 否则,更新max_reachable为max(max_reachable, i + nums[i]),即在当前位置i,尝试跳跃nums[i]步,更新最远可达位置。
- 如果在遍历过程中,max_reachable已经大于或等于最后一个下标,说明可以到达最后一个下标,返回True。
时间复杂度:该算法只需遍历数组一次,因此时间复杂度为 O(n)。这是最优的时间复杂度,因为我们至少需要查看每个元素一次以确定是否可以到达最后一个位置。 空间复杂度:该算法只使用了常数个额外变量,因此空间复杂度为 O(1)。
代码#
1class Solution:
2    def canJump(self, nums: List[int]) -> bool:
3        max_reachable = 0
4        for i in range(len(nums)):
5            if i > max_reachable:
6                return False
7            max_reachable = max(max_reachable, i + nums[i])
8        return True
45. 跳跃游戏 II#
题目描述#
给定一个长度为n的0 索引整数数组nums。初始位置为nums[0]。
每个元素nums[i]表示从索引i向前跳转的最大长度。换句话说,如果你在nums[i]处,你可以跳转到任意nums[i + j]处:
0 <= j <= nums[i]i + j < n
返回到达nums[n - 1]的最小跳跃次数。生成的测试用例可以到达nums[n - 1]。
示例:
输入:nums = [2,3,1,1,4]
输出:2
解释:跳到最后一个位置的最小跳跃数是 2。
核心思路#
贪心策略:在每一步中,我们尝试跳到当前能够到达的最远位置,并在需要的时候增加跳跃次数。
变量初始化:
- max_reach:表示从当前及之前的位置能够到达的最远下标。
- steps:表示当前跳跃次数下能够到达的最远位置。
- jumps:记录跳跃次数,初始为 1,因为至少需要一次跳跃。
遍历数组:
- 从索引 1 开始遍历(因为起始位置已被初始化考虑)。
- 如果当前索引i超过了steps,这意味着需要进行一次新的跳跃才能继续前进,因此增加jumps并更新steps为max_reach。
- 每次更新max_reach为max(max_reach, i + nums[i]),以确保记录从当前位置能够到达的最远位置。
跳跃条件:
- 通过比较i和steps来决定是否增加跳跃次数。
- steps的更新保证了每次跳跃后能够尽可能远地前进。
时间复杂度:该算法只需遍历数组一次,因此时间复杂度为 O(n)。 空间复杂度:该算法只使用了常数个额外变量,因此空间复杂度为 O(1)。
代码#
 1class Solution:
 2    def jump(self, nums: List[int]) -> int:
 3        if len(nums) == 1:  # 如果数组只有一个元素,不需要跳跃
 4            return 0
 5
 6        max_reach = nums[0]  # 当前能够达到的最远位置
 7        steps = nums[0]      # 当前步数能够达到的最远位置
 8        jumps = 1            # 跳跃次数
 9
10        for i in range(1, len(nums)):
11            if i > steps:  # 如果当前位置超出了当前步数能够达到的最远位置
12                jumps += 1
13                steps = max_reach  # 更新当前步数能够达到的最远位置
14
15            max_reach = max(max_reach, i + nums[i])  # 更新当前能够达到的最远位置
16
17        return jumps
763. 划分字母区间#
题目描述#
给你一个字符串s。我们要把这个字符串划分为尽可能多的片段,同一字母最多出现在一个片段中。
注意,划分结果需要满足:将所有划分结果按顺序连接,得到的字符串仍然是s。
返回一个表示每个字符串片段的长度的列表。
示例:
输入:s = "ababcbacadefegdehijhklij"
输出:[9,7,8]
解释:
划分结果为 "ababcbaca"、"defegde"、"hijhklij" 。
每个字母最多出现在一个片段中。像 "ababcbacadefegde", "hijhklij" 这样的划分是错误的,因为划分的片段数较少。
核心思路#
记录最后出现位置:
- 先遍历字符串s,记录每个字符最后一次出现的位置。这样可以知道每个字符的活动范围。
划分片段:
- 用两个变量start和end来表示当前片段的起始和结束位置。
- 再次遍历字符串s:
- 对于每个字符s[i],我们更新end为该字符的最后出现位置和当前end的最大值。
- 如果当前索引i等于end,这意味着从start到end的片段可以独立出来,因为所有在这个片段中的字符都不会在后面出现。
记录结果:
- 当确定一个片段时,计算其长度end - start + 1,并将其加入结果列表。
- 更新start为i + 1,继续寻找下一个片段。
代码#
动态规划#
70. 爬楼梯#
题目描述#
假设你正在爬楼梯。需要n阶你才能到达楼顶。
每次你可以爬1或2个台阶。你有多少种不同的方法可以爬到楼顶呢?
示例:
输入:n = 2
输出:2
解释:有两种方法可以爬到楼顶。
1. 1 阶 + 1 阶
2. 2 阶
核心思路#
- 定义状态:用数组dp[i]表示爬到第i个台阶的方法数。
- 初始化:
- 爬 0 个台阶只有一种方法(即不动),所以dp[0] = 1。
- 爬 1 个台阶也只有一种方法(直接爬上去),所以dp[1] = 1。
- 状态转移方程:
- 要爬到第i个台阶,可以从第i-1个台阶爬 1 步到达,也可以从第i-2个台阶爬 2 步到达。
- 因此,dp[i] = dp[i-1] + dp[i-2]。
- 时间复杂度:
- 由于每个状态只依赖前两个状态,因此时间复杂度为O(n)。
代码#
1class Solution:
2    def climbStairs(self, n: int) -> int:
3        dp = [0] * (n + 1)
4        dp[0], dp[1] = 1, 1
5        for i in range(2, n + 1):
6            dp[i] = dp[i - 1] + dp[i - 2]
7        return dp[n]
118. 杨辉三角#
题目描述#
给定一个非负整数numRows,生成「杨辉三角」的前numRows行。
在「杨辉三角」中,每个数是它左上方和右上方的数的和。
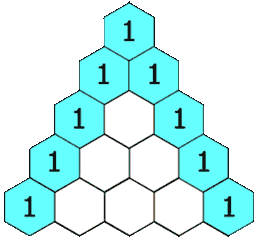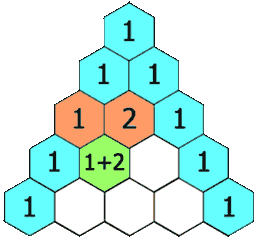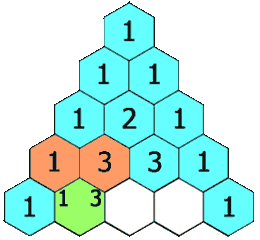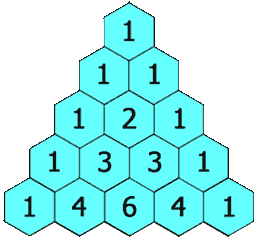
示例:
输入: numRows = 5
输出: [[1],[1,1],[1,2,1],[1,3,3,1],[1,4,6,4,1]]
核心思路#
- 初始化:
- 创建一个长度为numRows的二维列表triangle。
- 每行i都初始化为有i+1个元素的列表,其中第一个和最后一个元素都设为1,因为杨辉三角的两侧边界上的元素都是1。
- 填充中间部分:
- 从第三行开始(即索引为2),对每一行的中间元素进行动态规划计算。
- 对于triangle[i][j],它等于上一行的两个元素之和:triangle[i-1][j-1] + triangle[i-1][j]。
- 返回结果:
- 最后返回整个triangle。
代码#
 1class Solution:
 2    def generate(self, numRows: int) -> List[List[int]]:
 3        if numRows <= 0:
 4            return []
 5        # Initialize the first row
 6        triangle = [[1]]
 7
 8        for i in range(1, numRows):
 9            row = [1] * (i + 1)  # First step: initialize current row with 1s
10            for j in range(1, i):  # Second step: fill the middle elements
11                row[j] = triangle[i-1][j-1] + triangle[i-1][j]
12            triangle.append(row)
13
14        return triangle
198. 打家劫舍#
题目描述#
你是一个专业的小偷,计划偷窃沿街的房屋。每间房内都藏有一定的现金,影响你偷窃的唯一制约因素就是相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警。
给定一个代表每个房屋存放金额的非负整数数组,计算你不触动警报装置的情况下,一夜之内能够偷窃到的最高金额。
示例 :
输入:[1,2,3,1]
输出:4
解释:偷窃 1 号房屋 (金额 = 1) ,然后偷窃 3 号房屋 (金额 = 3)。偷窃到的最高金额 = 1 + 3 = 4 。
核心思路#
这个问题可以使用动态规划方法来解决。动态规划的核心思想是将复杂的问题分解成更小的子问题,并利用这些子问题的解来构建原问题的解。
- 定义状态:
- 设dp[i]表示偷窃到第i个房屋时能够获得的最大金额。
- 状态转移方程:
- 对于每个房屋i,有两种选择:
- 不偷这个房屋,那么dp[i] = dp[i-1]。
- 偷这个房屋,那么dp[i] = dp[i-2] + nums[i],因为不能偷相邻的房屋。
- 因此,状态转移方程为:dp[i] = max(dp[i-1], dp[i-2] + nums[i])。
- 对于每个房屋i,有两种选择:
- 初始条件:
- dp[0] = nums[0],因为只有一个房屋时,只能偷这个房屋。
- dp[1] = max(nums[0], nums[1]),因为有两个房屋时,可以选择偷其中一个金额较大的房屋。
- 优化空间复杂度:
- 由于每次计算dp[i]只依赖于dp[i-1]和dp[i-2],可以使用两个变量来代替整个数组,从而将空间复杂度从O(n)优化到O(1)。
代码#
 1class Solution:
 2    def rob(self, nums: List[int]) -> int:
 3        if not nums:
 4            return 0
 5        if len(nums) == 1:
 6            return nums[0]
 7
 8        # 初始化前两个状态
 9        prev1 = nums[0]
10        prev2 = max(nums[0], nums[1])
11
12        # 从第三个房屋开始计算
13        for i in range(2, len(nums)):
14            # 当前状态
15            current = max(prev2, prev1 + nums[i])
16            # 更新前两个状态
17            prev1 = prev2
18            prev2 = current
19
20        return prev2
279. 完全平方数#
题目描述#
给你一个整数n,返回_和为n的完全平方数的最少数量_。
完全平方数是一个整数,其值等于另一个整数的平方;换句话说,其值等于一个整数自乘的积。例如,1、4、9和16都是完全平方数,而3和11不是。
示例:
输入:n = 12
输出:3
解释:12 = 4 + 4 + 4
核心思路#
这道题的本质是找到一个整数n可以被分解成最少的完全平方数之和。我们可以通过定义一个数组dp来存储每个值的最优解,从而逐步构建出最终的解。
- 定义状态:
- dp[i] 表示 凑成 i 这个数时,最少需要几个完全平方数的和。
- 初始化:
- dp[0] = 0,因为凑成 0 这个数不需要任何数。
- 其他dp[i]初始值可以设为正无穷大(表示还未找到解)。
- 状态转移:
- 对于每个i,我们可以通过减去一个完全平方数jj来得到i,其中jj <= i。
- 当 i = 12 时,我们可以尝试减去 1², 2², 3²,因为 1², 2², 3² 都是小于 12 的完全平方数。
- 如果用 1²,我们就要看 dp[12 - 1] 的值;
- 如果用 2²,我们就要看 dp[12 - 4] 的值;
- 如果用 3²,我们就要看 dp[12 - 9] 的值。
- 状态转移方程为:dp[i] = min(dp[i], dp[i - jj] + 1),其中1表示我们使用了一个完全平方数jj。
- 对于每个i,我们可以通过减去一个完全平方数jj来得到i,其中jj <= i。
- 结果:
- 最终dp[n]就是我们要找的答案。
代码#
 1class Solution:
 2    def numSquares(self, n: int) -> int:
 3
 4        # 创建一个长度为 n+1 的数组 dp
 5        dp = [float('inf')] * (n + 1)
 6
 7        # 初始化 dp[0] 为 0,因为凑成 0 不需要任何数
 8        dp[0] = 0
 9
10        # 从 1 开始,逐步计算 dp[i] 的最优解
11        for i in range(1, n + 1):
12            # 尝试每一个小于 i 的平方数 j*j
13            j = 1
14            while j * j <= i:
15                dp[i] = min(dp[i], dp[i - j * j] + 1)
16                j += 1
17
18        # 最终答案在 dp[n]
19        return dp[n]
322. 零钱兑换#
题目描述#
给你一个整数数组coins,表示不同面额的硬币;以及一个整数amount,表示总金额。
计算并返回可以凑成总金额所需的最少的硬币个数。如果没有任何一种硬币组合能组成总金额,返回-1。
你可以认为每种硬币的数量是无限的。
示例:
输入:coins = [1, 2, 5], amount = 11
输出:3
解释:11 = 5 + 5 + 1
核心思路#
- 定义状态:
- dp[i] 表示 凑成金额 i 时,最少需要硬币的个数。
- 初始化:
- dp[0] = 0,因为凑成 0 元不需要任何硬币。
- 其他dp[i]初始值可以设为正无穷大(表示还未找到解)。
- 状态转移:
- 对于每一个金额 i,我们要检查所有的硬币面额 coins 中,能否通过减去某个硬币来得到更少的硬币数量。
- 状态转移方程为:dp[i] = min(dp[i], dp[i - coin] + 1),其中1表示我们使用了一个 coin。
- 结果:
- 最终dp[amount]就是我们要找的答案。
代码#
 1class Solution:
 2    def coinChange(self, coins: List[int], amount: int) -> int:
 3        # 初始化dp数组,dp[i]表示凑成i元最少需要的硬币数量
 4        dp = [float('inf')] * (amount + 1)
 5        dp[0] = 0  # 凑成0元需要0个硬币
 6
 7        # 从1元开始,逐步计算每个金额的最优解
 8        for i in range(1, amount + 1):
 9            # 遍历所有硬币面额
10            for coin in coins:
11                if i - coin >= 0:  # 如果当前硬币可以用来凑成i
12                    dp[i] = min(dp[i], dp[i - coin] + 1)
13
14        # 如果dp[amount]仍然是无穷大,说明无法凑成该金额
15        return dp[amount] if dp[amount] != float('inf') else -1
139. 单词拆分#
题目描述#
给你一个字符串s和一个字符串列表wordDict作为字典。如果可以利用字典中出现的一个或多个单词拼出s则返回true。
注意:不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
示例:
输入:s = "leetcode", wordDict = ["leet", "code"]
输出:true
解释:返回 true 因为 "leetcode" 可以由 "leet" 和 "code" 拼接成。
核心思路#
- 定义状态:
- 用一个布尔数组 dp 来表示
- dp[i] 为 True 表示 前 i 个字符可以用 wordDict 中的单词拼接而成,
- dp[i] 为 False 则表示不能拼接。
- 初始化:
- dp[0] = True,因为空字符串可以通过不使用任何单词构成。
- 其他dp[i]初始值为 False。
- 状态转移:
- 对于每个 i,我们要检查之前的每个位置 j 切分出来的字串是否在 wordDict 中,如果 dp[j] 是 True 且 s[j:i] 在 wordDict 中,那么 dp[i] 也设置为 True。
- 状态转移方程为:dp[i] = dp[j] and (s[j:i] ∈ wordDict) 其中 0≤j<i。
- 结果:
- 最终 dp[len(s)] 就表示整个字符串 s 是否能被拆分成字典中的单词。
代码#
 1class Solution:
 2    def wordBreak(self, s: str, wordDict: List[str]) -> bool:
 3        # 将 wordDict 转换为集合,方便查找
 4        word_set = set(wordDict)
 5        # 创建一个长度为 len(s) + 1 的数组 dp,初始为 False
 6        dp = [False] * (len(s) + 1)
 7        # 初始化 dp[0] 为 True,因为空字符串是可以构成的
 8        dp[0] = True
 9
10        # 遍历字符串的每一个位置 i
11        for i in range(1, len(s) + 1):
12            # 对于每个位置 i,尝试从 j 切分
13            for j in range(i):
14                # 如果 dp[j] 为 True 且 s[j:i] 在字典中
15                if dp[j] and s[j:i] in word_set:
16                    dp[i] = True
17                    break  # 已经找到一个方案,不需要继续切分
18
19        # 最终结果在 dp[len(s)]
20        return dp[len(s)]
300. 最长递增子序列#
题目描述#
给你一个整数数组nums,找到其中最长严格递增子序列的长度。
子序列是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。例如,[3,6,2,7]是数组[0,3,1,6,2,2,7]的子序列。
示例:
输入:nums = [10,9,2,5,3,7,101,18]
输出:4
解释:最长递增子序列是 [2,3,7,101],因此长度为 4 。
核心思路#
- 初始化:
- tails = []。这个数组最终会保存每个长度的递增子序列的最小结尾值。
- 如果 tails[2] = 7,表示存在一个长度为 3 的递增子序列,其结尾元素为 7。
- 为什么关心最小结尾元素?因为最小的结尾使得后续的序列更有可能继续延展,从而形成更长的递增子序列。
- 定义 binary_search 函数:二分查找用来找到 tails 中第一个大于等于目标值 target 的位置。该函数返回的 left 就是我们需要插入或替换的索引位置。
- 遍历 nums 数组:
- 对于每个 num,在 tails 中通过二分查找找到第一个大于等于 num 的位置 idx。
- 如果 num 比 tails 中所有元素都大,即 idx == len(tails),则将 num 添加到 tails 末尾。
- 如果找到了合适的位置 idx,则替换掉 tails[idx],表示找到了一个更小的结尾元素,使得当前长度的递增子序列更有潜力继续延展。
- 最终返回 tails 数组的长度:tails 的长度即为最长递增子序列的长度。
示例
以输入 [10, 9, 2, 5, 3, 7, 101, 18] 为例:
- 初始化 tails = []。
- 遍历第一个元素 10:
- tails 是空的,所以将 10 添加到 tails 中:tails = [10]。
- 遍历第二个元素 9:
- 9 小于 10,所以用 9 替换 tails[0],得到 tails = [9]。
- 遍历第三个元素 2:
- 2 小于 9,所以用 2 替换 tails[0],得到 tails = [2]。
- 遍历第四个元素 5:
- 5 大于 2,将 5 添加到 tails 末尾:tails = [2, 5]。
- 遍历第五个元素 3:
- 3 大于 2 但小于 5,用 3 替换 tails[1],得到 tails = [2, 3]。
- 遍历第六个元素 7:
- 7 大于 3,将 7 添加到 tails 末尾:tails = [2, 3, 7]。
- 遍历第七个元素 101:
- 101 大于 7,将 101 添加到 tails 末尾:tails = [2, 3, 7, 101]。
- 遍历最后一个元素 18:
- 18 小于 101 但大于 7,用 18 替换 tails[3],得到 tails = [2, 3, 7, 18]。
最终 tails 数组的长度为 4,因此最长递增子序列的长度为 4。
贪心策略:通过维护一个 tails 数组,确保对于每个可能长度的递增子序列,其结尾元素尽可能小,以便后续元素更容易接上。 二分查找:在 tails 中找到可以插入或替换的位置,用二分查找加速这个过程,从而将整体时间复杂度优化到 O(nlogn)。
代码#
 1class Solution:
 2    def lengthOfLIS(self, nums: List[int]) -> int:
 3        # tails 数组记录每个长度的递增子序列的最小结尾值
 4        tails = []
 5
 6        # 手动实现二分查找,用于找到 tails 中第一个大于等于 target 的位置
 7        def binary_search(tails, target):
 8            left, right = 0, len(tails) - 1
 9            while left <= right:
10                mid = left + (right - left) // 2
11                if tails[mid] < target:
12                    left = mid + 1
13                else:
14                    right = mid - 1
15            return left
16
17        for num in nums:
18            # 找到 tails 中第一个大于等于 num 的位置
19            idx = binary_search(tails, num)
20
21            # 如果没有找到合适的位置,说明 num 大于 tails 中的所有元素
22            if idx == len(tails):
23                tails.append(num)
24            else:
25                # 用 num 替换掉 tails[idx],使得结尾元素尽可能小
26                tails[idx] = num
27
28        # 最终 tails 数组的长度就是最长递增子序列的长度
29        return len(tails)
152. 乘积最大子数组#
题目描述#
给你一个整数数组nums,请你找出数组中乘积最大的非空连续子数组(该子数组中至少包含一个数字),并返回该子数组所对应的乘积。
测试用例的答案是一个32位整数。
示例:
输入:nums = [2,3,-2,4]
输出: 6
解释:子数组 [2,3] 有最大乘积 6。
核心思路#
该题的关键在于处理正负数的影响,因为负数的乘积可能会使最小值变成最大值。因此,需要特别关注如何维护最大值和最小值。
为了在遍历数组的过程中随时保持最大和最小的乘积,关键是要同时记录当前位置之前的最大乘积和最小乘积。原因如下: - 当前的数字如果是正数,我们希望它乘以之前的最大乘积,得到一个更大的值。 - 当前的数字如果是负数,那么我们希望它乘以之前的最小乘积,因为负负得正,可能得到更大的值。 因此,我们需要在每一步同时跟踪最大乘积和最小乘积,并通过更新它们来保证遍历结束时可以得到全局的最大乘积。
- 定义状态
- max_prod[i]:表示以 nums[i] 结尾的子数组的最大乘积。
- min_prod[i]:表示以 nums[i] 结尾的子数组的最小乘积(负数的可能性)。
- 初始化:
- max_prod[0] = nums[0]:因为以第一个元素开始的子数组的最大乘积就是它自己。
- min_prod[0] = nums[0]:同理,以第一个元素开始的子数组的最小乘积也是它自己。
- 状态转移方程:
- 如果 nums[i] 是正数,则 max_prod[i] = max(max_prod[i-1] * nums[i], nums[i])。
- 如果 nums[i] 是负数,则 max_prod[i] = max(min_prod[i-1] * nums[i], nums[i]),因为负数会反转最大和最小的关系。
代码#
 1class Solution:
 2    def maxProduct(self, nums: List[int]) -> int:
 3        # 初始化最大乘积和最小乘积
 4        current_max = current_min = global_max = nums[0]
 5
 6        # 从第二个元素开始遍历
 7        for i in range(1, len(nums)):
 8            num = nums[i]
 9            temp_max = current_max
10
11            # 更新 current_max 和 current_min
12            current_max = max(num, current_max * num, current_min * num)
13            current_min = min(num, temp_max * num, current_min * num)
14
15            # 更新全局最大值
16            global_max = max(global_max, current_max)
17
18        return global_max
416. 分割等和子集#
题目描述#
给你一个只包含正整数的非空数组nums。请你判断是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。
示例:
输入:nums = [1,5,11,5]
输出:true
解释:数组可以分割成 [1, 5, 5] 和 [11] 。
核心思路#
这道题是一个经典的 0/1 背包问题,给定一个数组 nums,我们需要判断是否能够将它分割成两个子集,使得两个子集的元素和相等。 我们可以将问题转换为:是否能从数组中挑选出若干个元素,使得它们的和等于整个数组总和的一半。
假设数组的总和为 S,如果 S 是奇数,那么无法平分为两个相等的子集,直接返回 False。 如果 S 是偶数,那么我们的问题就变成了:是否能从数组中找到一个子集,使得该子集的和等于 S / 2。
我们可以把问题看作是一个 0/1 背包问题: - 背包容量是 S / 2,即我们需要找的子集的目标和。 - 每个数组元素代表可以选择或不选择的一件物品,物品的重量就是数组中的元素值。 目标是判断是否存在一种选择方案,能够让这些元素的和恰好等于 S / 2。
用一个动态规划的数组 dp 来解决这个问题,其中 dp[i] 表示是否能找到一个子集,使得这个子集的和等于 i。
状态定义:
- 定义一个布尔数组 dp ,其中 dp[j] 表示能否从数组中找到和为 j 的子集。
状态转移:
- 对于每个数组中的数字 num,我们从右向左遍历 dp 数组,检查能否通过选择这个 num 来更新 dp[j]。
- 具体来说,dp[j] 可以由 dp[j - num] 推导出来,表示如果之前存在和为 j - num 的子集,那么加上 num 后就可以得到和为 j 的子集。
- 因此,状态转移方程为: dp[j] = dp[j] or dp[j − num]
初始化:
- dp[0] = True,表示和为 0 的子集肯定是存在的(即不选任何元素)。
结果:
- 在遍历完数组 nums 后,检查 dp[S/2] 是否为 True,如果是,则表示存在子集和为 S/2,即可以分割为两个和相等的子集。
代码#
 1class Solution:
 2    def canPartition(self, nums: List[int]) -> bool:
 3        total_sum = sum(nums)
 4
 5        # 如果总和是奇数,无法平分成两个子集
 6        if total_sum % 2 != 0:
 7            return False
 8
 9        target = total_sum // 2
10
11        # 初始化 dp 数组,dp[j] 表示是否能找到和为 j 的子集
12        dp = [False] * (target + 1)
13        dp[0] = True  # 和为0的子集肯定存在
14
15        # 遍历数组中的每个数字
16        for num in nums:
17            # 从 target 到 num 进行逆序遍历,防止重复使用同一个数字
18            for j in range(target, num - 1, -1):
19                dp[j] = dp[j] or dp[j - num]
20
21        # 返回是否能找到和为 target 的子集
22        return dp[target]
多维动态规划#
62. 不同路径#
题目描述#
一个机器人位于一个m x n网格的左上角 (起始点在下图中标记为 “Start” )。
机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为 “Finish” )。
问总共有多少条不同的路径?
示例:

输入:m = 3, n = 7
输出:28
核心思路#
机器人要完成整个移动,必须走 m-1 次向下和 n−1 次向右。因此,总共需要走的步数是 m+n−2 步。 因此,问题可以看作从 m+n−2 个位置中选择 m−1 个位置向下,剩下的向右。
这就是组合数问题,公式为:C(m+n−2,m−1) = (m+n−2)! / (m−1)!(n−1)!
代码#
class Solution:
	def uniquePaths(self, m: int, n: int) -> int:
		return math.comb(m + n - 2, m - 1)
64. 最小路径和#
题目描述#
给定一个包含非负整数的_m_x_n_网格grid,请找出一条从左上角到右下角的路径,使得路径上的数字总和为最小。
说明:每次只能向下或者向右移动一步。
示例:
输入:grid = [[1,3,1],[1,5,1],[4,2,1]]
输出:7
解释:因为路径 1→3→1→1→1 的总和最小。
核心思路#
定义状态:
- 设 dp[i][j] 为到达位置 (i, j) 的最小路径和。
状态转移方程:
- 从左上角 (0, 0) 开始,移动到 (i, j) 只能从上方 (i-1, j) 或左方 (i, j-1) 移动过来。
- 因此,状态转移方程为:dp[i][j] = grid[i][j] + min(dp[i-1][j], dp[i][j-1])
- 需要注意边界条件:
- 当 i = 0 时,只能从左边移动:dp[0][j] = dp[0][j-1] + grid[0][j]
- 当 j = 0 时,只能从上边移动:dp[i][0] = dp[i-1][0] + grid[i][0]
初始化:
- dp[0][0] = grid[0][0],即起点的值。
计算:
- 通过双重循环遍历整个 grid,根据状态转移方程填充 dp 数组。
结果:
- 最终结果为 dp[m-1][n-1],即到达右下角的最小路径和。
代码#
 1class Solution:
 2    def minPathSum(self, grid: List[List[int]]) -> int:
 3        m = len(grid)
 4        n = len(grid[0])
 5
 6        # 创建一个二维数组 dp,用于存储到达每个点的最小路径和
 7        dp = [[0] * n for _ in range(m)]
 8
 9        dp[0][0] = grid[0][0]
10
11        # 填充第一行(只能从左边移动)
12        for j in range(1, n):
13            dp[0][j] = dp[0][j - 1] + grid[0][j]
14
15        # 填充第一列(只能从上面移动)
16        for i in range(1, m):
17            dp[i][0] = dp[i - 1][0] + grid[i][0]
18
19        # 填充剩余的 dp 数组
20        for i in range(1, m):
21            for j in range(1, n):
22                # 当前点的最小路径和 = 当前点的值 + 上方和左方的最小路径和
23                dp[i][j] = grid[i][j] + min(dp[i - 1][j], dp[i][j - 1])
24
25        return dp[m - 1][n - 1]
5. 最长回文子串#
题目描述#
给你一个字符串s,找到s中最长的回文子串。
示例:
输入:s = "babad"
输出:"bab"
解释:"aba" 同样是符合题意的答案。
核心思路#
回文字符串是对称的,我们可以从每个字符或者字符之间的缝隙作为中心,向两边扩展,检查最长的回文子串。 具体地,对于每个可能的中心,向两边扩展,直到不再是回文子串为止。维护当前发现的最长回文子串。
代码#
 1class Solution:
 2    def longestPalindrome(self, s: str) -> str:
 3        if len(s) < 2:
 4            return s
 5
 6        # 定义一个函数,从中心向两边扩展,找到最长的回文子串
 7        # 参数 left 和 right 分别是左右边界
 8        def expandAroundCenter(s, left, right):
 9            # 当左右边界在有效范围内,且 s[left] == s[right] 时,继续向外扩展
10            while left >= 0 and right < len(s) and s[left] == s[right]:
11                left -= 1  # 向左扩展
12                right += 1  # 向右扩展
13            # 返回扩展后的回文子串的实际左右边界(因为最后一次循环会多减/加一,所以要 +1 和 -1)
14            return left + 1, right - 1
15
16        # 初始化回文子串的起始和结束索引
17        start, end = 0, 0
18
19        # 遍历字符串的每一个字符,以其作为中心进行扩展
20        for i in range(len(s)):
21            # 第一种情况:以 s[i] 作为中心,检查长度为奇数的回文子串
22            l1, r1 = expandAroundCenter(s, i, i)
23            # 第二种情况:以 s[i] 和 s[i+1] 之间的空隙作为中心,检查长度为偶数的回文子串
24            l2, r2 = expandAroundCenter(s, i, i + 1)
25
26            # 如果奇数长度的回文子串比当前记录的最长回文子串更长,更新 start 和 end
27            if r1 - l1 > end - start:
28                start, end = l1, r1
29            # 如果偶数长度的回文子串比当前记录的最长回文子串更长,更新 start 和 end
30            if r2 - l2 > end - start:
31                start, end = l2, r2
32
33        # 返回最长回文子串,使用最终的 start 和 end 索引
34        return s[start:end + 1]
1143. 最长公共子序列#
题目描述#
给定两个字符串text1和text2,返回这两个字符串的最长公共子序列的长度。如果不存在公共子序列,返回0。
一个字符串的子序列是指这样一个新的字符串:它是由原字符串在不改变字符的相对顺序的情况下删除某些字符(也可以不删除任何字符)后组成的新字符串。
- 例如,
"ace"是"abcde"的子序列,但"aec"不是"abcde"的子序列。
两个字符串的公共子序列是这两个字符串所共同拥有的子序列。
示例:
输入:text1 = "abcde", text2 = "ace"
输出:3
解释:最长公共子序列是 "ace" ,它的长度为 3 。
核心思路#
定义动态规划表(DP表):
- 我们定义一个二维数组 dp,其中 dp[i][j] 表示字符串 text1 的前 i 个字符和字符串 text2 的前 j 个字符的最长公共子序列长度。
- dp[i][j] 记录了到目前为止,text1[0:i-1] 和 text2[0:j-1] 的最长公共子序列长度。
状态转移方程:
- 如果 text1[i-1] == text2[j-1],这说明 text1 和 text2 的当前字符相同,我们可以把这个公共字符加入最长公共子序列,因此:dp[i][j] = dp[i−1][j−1] + 1
- 如果 text1[i-1] != text2[j-1],则 dp[i][j] = max(dp[i−1][j],dp[i][j−1]) 这表示我们要么忽略 text1 的当前字符,要么忽略 text2 的当前字符,取两种情况中较大的子序列长度。
边界条件:
- 当 i == 0 或 j == 0 时,dp[i][j] 都初始化为 0,因为一个空字符串与任何字符串的公共子序列长度为 0。
最终结果:
- 填充完 DP 表后,dp[m][n](其中 m 是 text1 的长度,n 是 text2 的长度)就是最长公共子序列的长度。
代码#
 1class Solution:
 2    def longestCommonSubsequence(self, text1: str, text2: str) -> int:
 3        # 获取两个字符串的长度
 4        m, n = len(text1), len(text2)
 5
 6        # 初始化 DP 表,dp[i][j] 表示 text1[0:i] 和 text2[0:j] 的最长公共子序列长度
 7        dp = [[0] * (n + 1) for _ in range(m + 1)]
 8
 9        # 填充 DP 表
10        for i in range(1, m + 1):
11            for j in range(1, n + 1):
12                if text1[i - 1] == text2[j - 1]:
13                    # 当前字符相同,公共子序列长度加1
14                    dp[i][j] = dp[i - 1][j - 1] + 1
15                else:
16                    # 当前字符不相同,取两个可能情况的最大值
17                    dp[i][j] = max(dp[i - 1][j], dp[i][j - 1])
18
19        # 返回最终的最长公共子序列长度
20        return dp[m][n]
72. 编辑距离#
题目描述#
给你两个单词word1和word2,请返回将word1转换成word2所使用的最少操作数。
你可以对一个单词进行如下三种操作:
- 插入一个字符
- 删除一个字符
- 替换一个字符
示例:
输入:word1 = "horse", word2 = "ros"
输出:3
解释:
horse -> rorse (将 'h' 替换为 'r')
rorse -> rose (删除 'r')
rose -> ros (删除 'e')
核心思路#
定义 DP 表:我们定义一个二维数组 dp,其中 dp[i][j] 表示将 word1 的前 i 个字符转换为 word2 的前 j 个字符所需的最少操作数。
边界条件:
- 如果 i == 0,即 word1 是空字符串,那么我们需要 j 次插入操作来将 word2 拼出来,故 dp[0][j] = j。
- 如果 j == 0,即 word2 是空字符串,那么我们需要 i 次删除操作来将 word1 清空,故 dp[i][0] = i。
状态转移方程:
- 如果 word1[i-1] == word2[j-1],表示两个字符相同,不需要任何操作:dp[i][j] = dp[i-1][j-1]。
- 如果 word1[i-1] != word2[j-1],表示两个字符不同,需要执行一次操作(插入、删除、替换),我们取三种操作中最小的那个: dp[i][j] = min(dp[i−1][j]+1, dp[i][j−1]+1, dp[i−1][j−1]+1)
- 删除操作:dp[i-1][j] + 1(从 word1 删除一个字符)
- 插入操作:dp[i][j-1] + 1(在 word1 插入一个字符)
- 替换操作:dp[i-1][j-1] + 1(将 word1 的当前字符替换成 word2 的字符)
最终结果:dp[m][n],其中 m 是 word1 的长度,n 是 word2 的长度。
代码#
 1class Solution:
 2    def minDistance(self, word1: str, word2: str) -> int:
 3        m, n = len(word1), len(word2)
 4        dp = [[0] * (n + 1) for _ in range(m + 1)]
 5
 6        for i in range(1, m + 1):
 7            dp[i][0] = i  # 从 word1[0:i] 变成空字符串,执行 i 次删除操作
 8        for j in range(1, n + 1):
 9            dp[0][j] = j  # 从空字符串变成 word2[0:j],执行 j 次插入操作
10
11        for i in range(1, m + 1):
12            for j in range(1, n + 1):
13                if word1[i - 1] == word2[j - 1]:
14                    dp[i][j] = dp[i - 1][j - 1]
15                else:
16                    # 如果不同,取插入、删除、替换操作的最小值,并加1表示一次操作
17                    dp[i][j] = min(dp[i - 1][j] + 1,    # 删除
18                                   dp[i][j - 1] + 1,    # 插入
19                                   dp[i - 1][j - 1] + 1)  # 替换
20
21        # 返回最终的最少操作次数
22        return dp[m][n]
技巧#
136. 只出现一次的数字#
题目描述#
给你一个非空整数数组nums,除了某个元素只出现一次以外,其余每个元素均出现两次。找出那个只出现了一次的元素。
你必须设计并实现线性时间复杂度的算法来解决此问题,且该算法只使用常量额外空间。
示例:
输入:nums = [2,2,1]
输出:1
核心思路#
异或运算的性质
- 任何数与0异或为其本身:
a ⊕ 0 = a - 任何数与其自身异或为0:
a ⊕ a = 0
利用异或运算性质,我们可以在O(n)时间复杂度和O(1)空间复杂度内找到只出现一次的数字。 因为对于任意两个相同的数,异或后结果为0。而0与任何数异或结果为该数本身。所以,所有成对出现的数在异或后都抵消为0,最终剩下的就是那个只出现一次的数。
具体步骤如下:
- 初始化变量result为0。
- 遍历数组,对每个元素执行异或运算并更新result。
- 最终,result的值即为只出现一次的那个数字。
代码#
1class Solution:
2    def singleNumber(self, nums: List[int]) -> int:
3        result = 0
4        for num in nums:
5            result ^= num
6        return result
169. 多数元素#
题目描述#
给定一个大小为n的数组nums,返回其中的多数元素。多数元素是指在数组中出现次数大于⌊ n/2 ⌋的元素。
你可以假设数组是非空的,并且给定的数组总是存在多数元素。
示例:
输入:nums = [3,2,3]
输出:3
核心思路#
【方法一:哈希表】
- 记录次数:
- 使用一个哈希表counts来记录每个元素出现的次数。
- 遍历数组nums,对每个元素进行统计。
- 如果元素已经在哈希表中,则其对应的计数器加1;
- 如果不在,则初始化该元素的计数器为1。
- 查找多数元素:
- 遍历哈希表中的所有键值对,找到出现次数大于 [n/2] 的元素,并返回该元素。
时间复杂度:O(n),因为我们需要遍历数组一次来填充哈希表,然后再遍历哈希表一次来找到多数元素。 空间复杂度:O(n),因为最坏情况下,需要存储数组中所有不同的元素的计数。
【方法二:摩尔投票】
- 候选者和计数器:
- 维护一个变量candidate用于跟踪当前的候选多数元素,以及一个count计数器来表示candidate在目前遇到的元素中的净出现次数。
- 遍历数组:
- 如果count为 0,说明我们需要更换候选者,将当前元素设为新的候选者,并将count设为 1。
- 如果当前元素等于candidate,则count加 1。
- 如果当前元素不等于candidate,则count减 1。
- 最终候选者:
- 遍历完成后,candidate所指的元素就是数组的多数元素。
时间复杂度:O(n),因为我们只需要一次遍历数组。 空间复杂度:O(1),只使用了常数级别的额外空间。
代码#
【方法一:哈希表】
 1class Solution:
 2	def majorityElement(self, nums: List[int]) -> int:
 3	    counts = {}
 4	    for num in nums:
 5	        if num in counts:
 6	            counts[num] += 1
 7	        else:
 8	            counts[num] = 1
 9
10	    for key, value in counts.items():
11	        if value > len(nums) // 2:
12	            return key
【方法二:摩尔投票】
 1class Solution:
 2	def majorityElement(self, nums: List[int]) -> int:
 3	    candidate = None
 4	    count = 0
 5
 6	    for num in nums:
 7	        if count == 0:
 8	            candidate = num
 9	        count += (1 if num == candidate else -1)
10
11	    return candidate
75. 颜色分类#
题目描述#
给定一个包含红色、白色和蓝色、共n个元素的数组nums,原地对它们进行排序,使得相同颜色的元素相邻,并按照红色、白色、蓝色顺序排列。
我们使用整数0、1和2分别表示红色、白色和蓝色。
必须在不使用库内置的 sort 函数的情况下解决这个问题。
示例:
输入:nums = [2,0,2,1,1,0]
输出:[0,0,1,1,2,2]
核心思路#
初始化指针:
- low指针用于标记红色(0)的边界,初始为 0。
- mid指针用于遍历数组,初始为 0。
- high指针用于标记蓝色(2)的边界,初始为数组的最后一个索引。
遍历数组:
- 当mid指针小于等于high指针时,检查nums[mid]的值:
- 如果nums[mid] == 0:交换nums[low]和nums[mid],然后将low和mid都加 1。
- 如果nums[mid] == 1:mid加 1。
- 如果nums[mid] == 2:交换nums[mid]和nums[high],然后将high减 1。注意这里 mid不变,因为交换后需要再次检查mid位置的值。
- 当mid指针小于等于high指针时,检查nums[mid]的值:
代码#
 1class Solution:
 2    def sortColors(self, nums: List[int]) -> None:
 3        low, mid, high = 0, 0, len(nums) - 1
 4
 5        while mid <= high:
 6            if nums[mid] == 0:
 7                nums[low], nums[mid] = nums[mid], nums[low]
 8                low += 1
 9                mid += 1
10            elif nums[mid] == 1:
11                mid += 1
12            else:  # nums[mid] == 2
13                nums[mid], nums[high] = nums[high], nums[mid]
14                high -= 1
31. 下一个排列#
题目描述#
整数数组的一个排列 就是将其所有成员以序列或线性顺序排列。
- 例如,
arr = [1,2,3],以下这些都可以视作arr的排列:[1,2,3]、[1,3,2]、[3,1,2]、[2,3,1]。
整数数组的下一个排列是指其整数的下一个字典序更大的排列。更正式地,如果数组的所有排列根据其字典顺序从小到大排列在一个容器中,那么数组的下一个排列就是在这个有序容器中排在它后面的那个排列。如果不存在下一个更大的排列,那么这个数组必须重排为字典序最小的排列(即,其元素按升序排列)。
- 例如,
arr = [1,2,3]的下一个排列是[1,3,2]。 - 类似地,
arr = [2,3,1]的下一个排列是[3,1,2]。 - 而
arr = [3,2,1]的下一个排列是[1,2,3],因为[3,2,1]不存在一个字典序更大的排列。
给你一个整数数组nums,找出nums的下一个排列。
必须原地修改,只允许使用额外常数空间。
示例:
输入:nums = [1,2,3]
输出:[1,3,2]
核心思路#
- 找到第一个升序对:
- 从数组的末尾开始,找到第一个nums[i] < nums[i + 1]的位置i。
- 如果找不到这样的i,说明整个数组是降序的,直接反转整个数组即可得到最小排列。
- 找到比nums[i]大的最小数:
- 从数组的末尾开始,找到第一个nums[j] > nums[i]的位置j。
- 交换nums[i]和nums[j]。
- 反转剩余部分:
- 反转从i + 1到数组末尾的部分,使其变为升序。
代码#
 1class Solution:
 2    def nextPermutation(self, nums: List[int]) -> None:
 3        # Step 1: Find the first decreasing element from the right
 4        i = len(nums) - 2
 5        while i >= 0 and nums[i] >= nums[i + 1]:
 6            i -= 1
 7
 8        if i >= 0:  # If such an element is found
 9            # Step 2: Find the element just larger than nums[i] from the right
10            j = len(nums) - 1
11            while nums[j] <= nums[i]:
12                j -= 1
13            # Step 3: Swap elements at i and j
14            nums[i], nums[j] = nums[j], nums[i]
15
16        # Step 4: Reverse the elements from i+1 to end
17        nums[i + 1:] = reversed(nums[i + 1:])
287. 寻找重复数#
题目描述#
给定一个包含n + 1个整数的数组nums,其数字都在[1, n]范围内(包括1和n),可知至少存在一个重复的整数。
假设nums只有一个重复的整数,返回这个重复的数。
你设计的解决方案必须不修改数组nums且只用常量级O(1)的额外空间。
示例:
输入:nums = [1,3,4,2,2]
输出:2
核心思路#
将数组视为一个链表,其中每个元素的值指向下一个节点的索引。由于存在重复的数字,因此链表中必然存在环。
初始化快慢指针:
- 使用两个指针,slow和fast。初始时,它们都指向数组的第一个元素。
寻找相遇点:
- 让slow每次移动一步,而fast每次移动两步。
- 由于存在重复的数字,fast和 slow最终会在环中相遇。
找到环的入口:
- 将slow重置到数组的起始位置,而fast保持在相遇点。
- 这时,让slow和fast每次都移动一步。
- 当它们再次相遇时,相遇点即为环的入口,也就是重复数字所在的位置。
代码#
 1class Solution:
 2    def findDuplicate(self, nums: List[int]) -> int:
 3        # Step 1: Initialize the slow and fast pointers
 4        slow = nums[0]
 5        fast = nums[0]
 6
 7        # Step 2: Move slow pointer by 1 step and fast pointer by 2 steps
 8        # until they meet inside the cycle
 9        while True:
10            slow = nums[slow]
11            fast = nums[nums[fast]]
12            if slow == fast:
13                break
14
15        # Step 3: Find the entrance to the cycle
16        slow = nums[0]
17        while slow != fast:
18            slow = nums[slow]
19            fast = nums[fast]
20
21        return slow
内容来源声明#
本博文收录的题目描述、核心思路与 Python 题解代码均为原作者成果,本人只对内容进行了格式整理与排版,不对其创作归属作声明。
内容整理自开源项目 LeetCode_Hot100_Python,在此向原作者表示诚挚感谢。 若内容存在不妥或涉及侵权,请联系我删改。